「検索順位」を追うのはもう終わり? AI検索時代にSEO担当者が追跡・最適化すべきこと(前編)
なぜAI検索で「順位とクリック」を追っても成果が出ないのか? 従来のSEOモデルを捨て、新たな追跡・最適化戦略へ切り替えるべき理由を解説
8月31日 7:05
- AI検索になぜ新しいメンタルモデルが必要なのか、
- SEO担当者は何を追跡し、ブロックし、最適化すべきなのか
AI検索では、最適化の成果は、必ずしも「クリック」「検索順位」に現れるとは限らない。ブランドは「引用されないまま推奨される」こともあるし、直接的なクリックが発生しないコンバージョンを追跡するのは難しい。
これまでSEO担当者は、長年にわたり慣れ親しんだ方法で施策の成果を追跡してきた。アトリビューションが複雑になった場合でも、基本的なモデルは十分有効であり、チームは取り組みを計画、測定、正当化できた。
しかし、AI検索で状況が変わっており、以前と同じことをするだけでは、うまくいかない。
今回のWhiteboard Fridayでは、トム・カッパー氏がさまざまな質問に答える形で「SEOからAI検索への変化に適応していく考え方と方法」を解説してくれている:
具体的な質問は、次の9つだ:
- 「AIに対するSEO担当者の認識」と「AI検索の実際の仕組み」でもっともズレているものは何か?
- 「グラウンディング検索」はどのようなもので、企業が最適化していく際のポイントは?
- 「AI検索のためのプロンプト調査」と「従来の検索のためのロングテールキーワード調査」はどう違うのか?
- 自社サイトでボットをブロックすべき? すべきではない? どう判断すべき?
- LLMs.txtは廃れたのか、それとも見落とされている正当なユースケースがあるか?
- SEO担当者がプロンプト追跡でやってしまう最大の失敗は何か?
- 古いコンテンツは引用されにくくなっているのか? リライトすれば引用されやすくなるのか?
- グーグル検索は5年後も現在のような形で存在しているか?
- AIでのビジビリティに関して、今すぐ始めるべき技術的な取り組みは何か?
Q1~Q5は前編となるこの記事で解説し、Q6~Q9は後編で紹介する。それでは、順に見ていこう。
セクション1: AI検索の仕組み
Q1.「AIに対するSEO担当者の認識」と「AI検索の実際の仕組み」でもっともズレているものは何か?
最大のギャップはメンタルモデルだ。
AIは、突然キーワード検索に取って代わったわけではない。キーワード検索は、ChatGPTが登場するずっと前から衰退傾向にあった。そのため、AI検索が注目を集める前から、SEOに関する多くの前提はすでに時代遅れになっていた。
だからといって、AI検索がSEOと完全に切り離されているわけではない。誰かが「結局のところSEOと変わらない」と言うような場合には、「SEOとAI検索の両方に適用できる手法がある」ことを暗に示している。
たしかにそうなのだが、変えなければいけないものもある。そうした手法の「組み合わせ」「優先順位」「考え方」だ。
この業務を担うのに最も適した立場にいるのはSEO担当者であることに変わりはない。なぜなら、僕たちはすでにあらゆる検索環境でビジビリティを高めるために最適化する方法を理解しているからだ。
ただし、AIの回答を従来の検索順位と同じように扱ったり、古い戦略を調整することなく利用できると思い込んだりしてはいけない。
SEO担当者はAI検索に取り組むにあたって、「既存のSEOと手法を変えずに名前だけを変える」のではなく、「ビジビリティを理解するために用いる基本モデルを更新する」必要がある。
Q2.「グラウンディング検索」はどのようなもので、企業が最適化していく際のポイントは?
「グラウンディング検索」は、AIシステムがプロンプトに回答するために外部情報が必要だと判断したときに、AIシステムが行う外部検索のことだ。
たとえば、蝶に関する詩を書くように指示すると、AIは内部の学習データを利用してインモデル回答を生成するが、そのデータは何年も前のものかもしれない。
次のように尋ねると、回答が表示される前にほぼ間違いなくバックグラウンドで複数のグーグル検索が実行される:
トム・カッパーとは誰か? 彼の近況を教えて
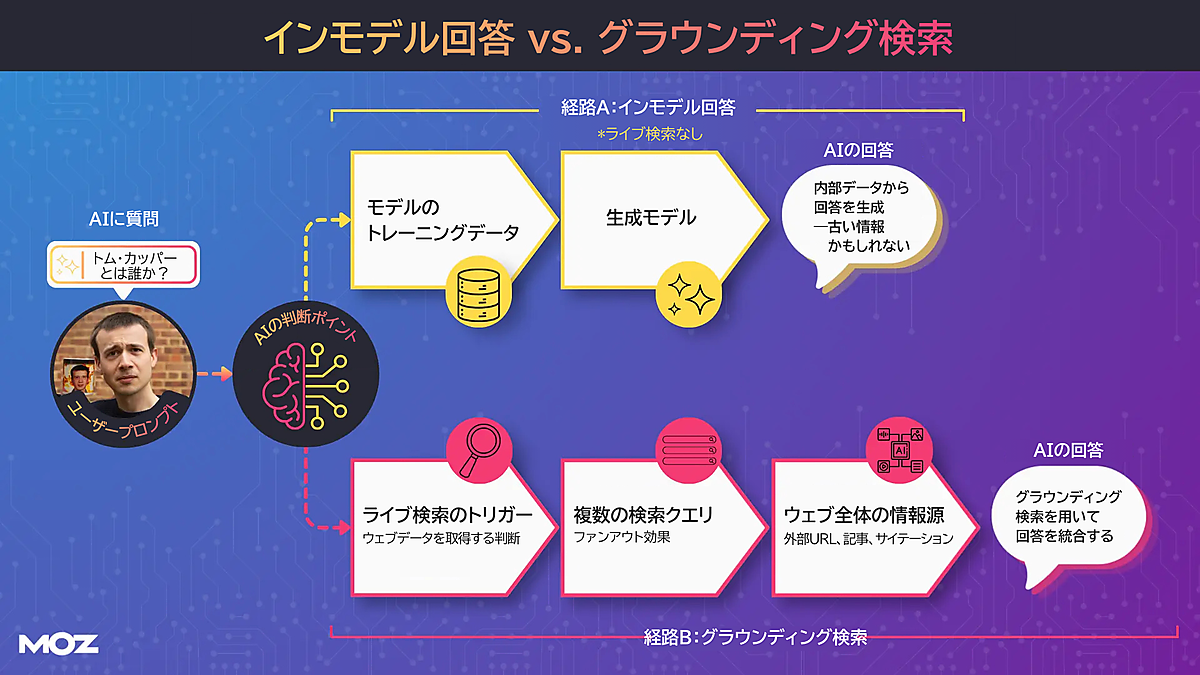
こうしたバックグラウンドでの検索は、プロンプトの追跡や調査のために理解しておく価値がある。ツールによっては検索フレーズをチャット内で表示していたり、ブラウザのコンソールで確認できたりする。グーグルもこの処理については、ファンアウト表示で(明確にではないが)暗に示している。
これらのツールが実行する検索は不可解なものもある。そのため、クエリそのものの順位を追跡することはお勧めしない。しかし、ビジビリティの仕組みにおける重要な変化は理解しておいてほしい。
SEO担当者はこれまで、次のように考えてきた:
このクエリに対して自分のサイトを表示させるにはどうすればいいか
今では、次のような問題になった:
「AIシステムが参照する情報源で、自分のブランドが正しく説明されている」状態にしていくには、どうすればいいか
これまでSEOといえば「自分のサイト」をどうするかの比重が高かった。
しかしAIシステムにとっては、情報源が「君のウェブサイト」か、それとも「他者のウェブサイト」かなど、どうでもいい。グラウンディング検索では、君のサイトでも外部サイトでも、最適な情報を得られる場所から情報を抽出する。
SEOにおいて、おそらくかつてないほどに、オフサイトでの(自社サイト以外での)取り組みが重視されるようになったということだ。実際、僕は以前これをデジタルPRと呼び、本格的な戦略の1つになりつつあると指摘した。
Q3.「AI検索のためのプロンプト調査」と「従来の検索のためのロングテールキーワード調査」はどう違うのか?
「プロンプト調査」は、「従来のキーワード調査」よりロングテールである傾向が強いため、プロンプトの正確なボリュームはあまり役に立たない。
クリックストリームデータなどの情報源からプロンプトのボリュームを把握することはできる。しかし、だからといってキーワードのボリュームと同じ価値があるわけではない。
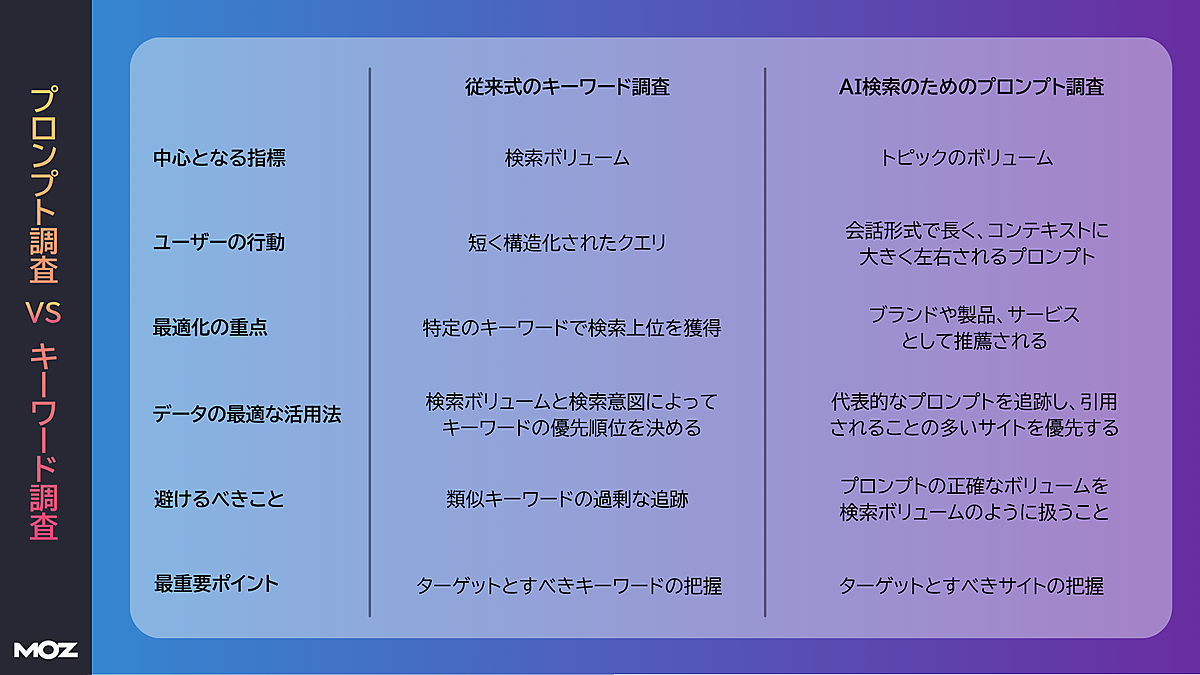
ほとんどのプロンプトは、「より長く」「より会話に近く」なっており、さらに「コンテキストに大きく左右される」ものだ。全体のボリュームが大きいプロンプト(検索ボリュームが大きいのと同じイメージ)があるとしたら、おそらく「ありがとう」といった会話のつなぎ言葉に過ぎないだろう。その意味は前後の会話によって決まるため、実際には誰にとっても最適化できるものではないだろう。
従来のSEOの場合、「検索ボリューム」は「どのクエリを優先すべきか」を判断する助けになっていた。AI検索の場合、より適切なアプローチは次のようなものだ:
- 関心のあるトピックを特定する
- それらのテーマを代表するプロンプトを追跡する
- 誰が引用されているか、自分のブランドがどのように表示されるかを把握する
- 時間が経つにつれて、そのトピックに関する回答がどのように変化するかを観察する
クエリファンアウト手法はこの方向性を示している。「特定のフレーズを検索した人の数」を調査するのではなく、「あるテーマについてどのようなトピックや意図が集まっているか」を調査し、「サイテーションがどのように変化するか」を追跡する。
有用なシグナルがあるのは、個々のプロンプトレベルではなく、トピックレベルだ。だからこそ、プロンプト調査は従来のキーワードモデルを模倣すべきではない。
セクション2: ボット戦略とクロールアクセス
Q4.自社サイトでボットをブロックすべき? すべきではない? どう判断すべき?
企業は、何をブロックするかを判断する前に、次の2つを区別する必要がある:
- 学習用ボット(トレーニングクローラー)
- グラウンディング用ボット(グラウンディングクローラー)
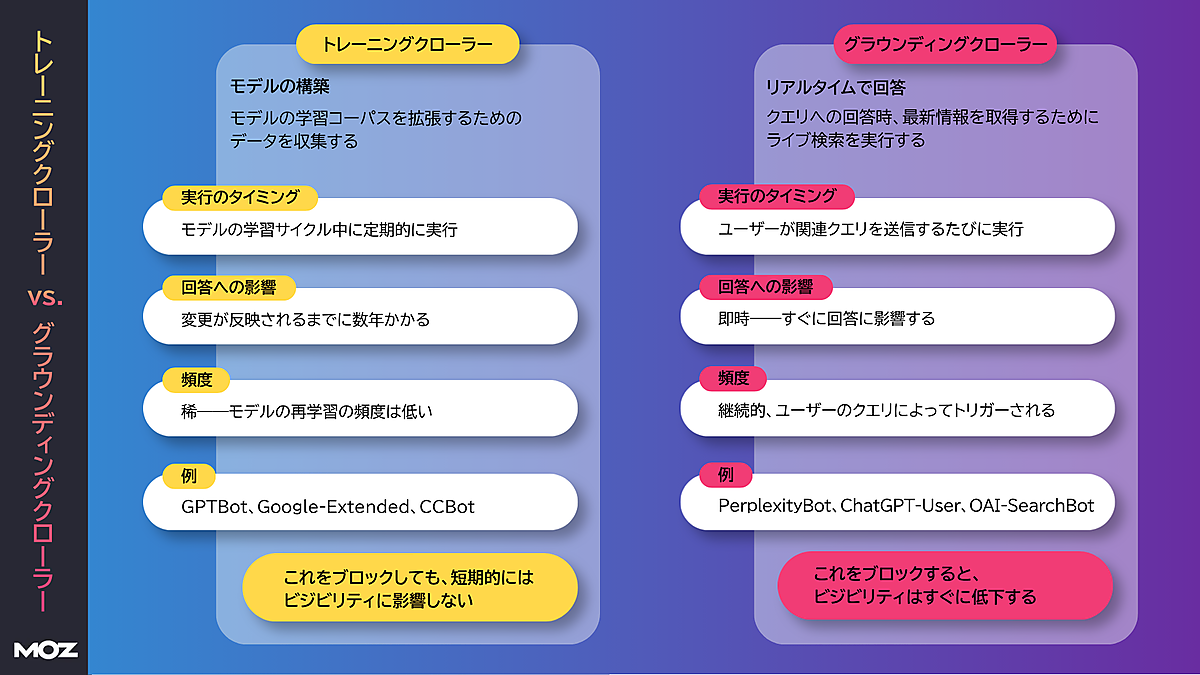
トレーニングクローラーは、AIの基盤モデルを支えるものだ。多くの場合、大規模モデルの再学習や置き換えには時間がかかるため、トレーニングクローラーをブロックしても数年は回答に変化はないように見えるかもしれない。
グラウンディングクローラーの仕組みは、トレーニング用クローラーとは異なる。これは「ライブ検索」「ウェブ検索」「ユーザーのクエリ」に対するリアルタイム回答に対応している。これをブロックすると、AIシステムが最新情報を必要とする際に君のコンテンツにアクセスできるかどうかに影響を与える可能性がある。
一部の大規模メディアには、特にAI企業との交渉やトラフィックベースのビジネスモデルの保護といった観点から、より積極的にブロックする正当な理由がある(たとえば、この調査で言及されているようなメディア)。しかし、ほとんどの企業サイトにとっては、グラウンディングクローラーにアクセスを許可しておくのが理にかなっている。
これはオフサイト戦略にも影響する。第三者によるカバレッジは、大規模言語モデル(LLM)がアクセスできる場合にのみ、AIでのビジビリティ向上に役立つ。それらのサイトがグラウンディングクローラーをブロックしていれば、ライブ検索でカバレッジが表示されない可能性がある。したがって、対象サイトがグラウンディングクローラーをブロックしていないか確認しておこう。
実践的なアプローチを次に示す:
自分がブロックしているユーザーエージェントを把握する(トレーニングクローラーか、それともグラウンディングクローラーか)
グラウンディングクローラーは、デフォルトではブロックしない。判断できない場合はブロックしない
グラウンディングクローラーをブロックすることにした場合は、ビジネス上の理由を明確にする
ブロックが自分のサイトと自分について言及している第三者のサイトの両方に与える影響を、時間をかけて理解する
Q5.LLMs.txtは廃れたのか、それとも見落とされている正当なユースケースがあるか?
僕はLLMs.txtをインチキなものと考えていたが、その後Anthropicがそのデータを収集していることを知った。AIのSEOには、グーグルが支配する世界では馴染みのない興味深いサイクルがある。「あるエンジンにとってはインチキなものが、別のエンジンにとっては本物にもなり得る」ということだ。
Anthropicが実際このデータをどう活用しているかはわからない。僕に言えるのは、君のAI SEO戦略がグーグル中心の場合(ほとんどの場合はそうあるべきだと僕は考えている)、LLMs.txtファイルは何の役にも立たないということだ。
とはいえ、LLMs.txtを実装するのにほぼ手間はかからないので、やってみるのもいいだろう。
Limyによる5億1500万件のLLMボットトラフィックイベントの分析では、主要なAIボットがこのファイルを活用している証拠はほとんど見つからなかった。しかし、AIエージェントがLLMs.txtを使っていることがあるのは確認された。
僕なら、現時点ではLLMs.txtにあまり時間をかけたくない。まず注力すべき、もっと有益な分野があるし、特にAIシステムが君のブランドについて説明するときに利用している情報源を把握することは重要だ。ただし、10分ほど手が空いていて、LLMs.txtファイルを作成できる状況にあるなら、やってみるのも悪くないかもしれない。
この記事は、前後編の2回に分けてお届けする。後編となる次回は今回に続いて、「適切な指標の測定」「オフサイト戦略とブランドナラティブ」「検索のこれから」に関する質問に答える。
- この記事のキーワード
関連記事

まだ「検索順位」を追っているの? AI検索時代にSEO担当者が測定・評価すべき5つの指標(後編)
9月7日 7:05

AI検索時代にブランドの存在感を高めるための4つのステップと測定方法(後編)
8月24日 7:05

AIによる概要やChatGPTに自社情報を出すには? 「インモデル」と「アウトオブモデル」を解説
6月15日 7:05

2026年のコンテンツ戦略、SERP機能はどうなる? SEOトレンドを専門家20人が予測(中編)
2月9日 7:05

AIでクリックは減った? いま狙うべき「質の高いコンテンツ」とは? 今すぐ学ぶべき事柄は? 10個のQ&Aで理解するAI+SEO【2026年版】
5月11日 7:05

AI検索でブランドを発見されやすくする方法(前編)
8月17日 7:05
バックナンバー


この記事の筆者
この記事は、Moz Blog に掲載された以下の記事を、Mozの許諾を得て日本語化したものです。
原文: 「Stop Measuring AI Search Like SEO: Here’s What To Track Instead」 by Tom Capper (2026/06/24)
筆者の人気記事

link rel="canonical"のようなURL正規化タグをSEOで有効活用するには
2009年3月5日 9:00

検索エンジンが順位を決める53の要因(39人のSEOプロが評価した重要度とコメント付き)
2007年10月1日 9:30

ホームページをGoogle検索に引っかからないようにする12の方法
2008年2月14日 9:00

サーチコンソールのHTMLタグはどこに? 所有権の確認など初心者ガイド
2015年11月9日 7:00

SEO基本技術のチートシート(トラの巻)を作ってみた
2008年6月9日 9:00

滅べばいいのにと思うSEOの10の迷信(都市伝説)
2010年6月14日 9:00