メンテ中に503は正しいけど、「robots.txtは200」がグーグル推奨。これは知らなかった!【SEOまとめ】
「メンテナンス時には503を返すこと。ただしrobots.txtは200を返すこと」――こんなガイドラインを渡辺隆広氏が紹介し、詳しく解説してくれている。
7:05
「メンテナンス時には503を返すこと。ただしrobots.txtは200を返すこと」――こんなガイドラインを渡辺隆広氏が紹介し、詳しく解説してくれている。
ほかにも、「E-E-A-Tスコア」「サイトマップ」「JPEG XL vs AVIF」といったピュアSEOのネタや、「AIで引用されたのは会社概要」「検索ボリューム0のクエリで競合にバレずに集客」といったネタが魅力だ。
グーグルが開始した新たなYouTubeチャネルも、ゲイリーが良いキャラを出していておもしろい。ぜひ動画で見てほしい。
今週も、あなたの仕事に役立つ情報を、ぜひ持ち帰っていただきたい。
- メンテ中に503は正しいけど、グーグル推奨は「robots.txtは200」。これは知らなかった!
- E-E-A-Tに「スコア」は存在しない! 著者情報を足しても順位が上がらない理由
- サイトマップ、まだ必要? グーグルが語る今も役立つ理由とよくある誤解
- 「JPEG XL」と「AVIF」、ウェブで写真を使うならどっち? 世界的なWeb開発者が徹底比較
- トップページの5倍の表示回数、AIOで最も引用されたのは会社概要ページだった!?
- 競合に気づかれずに見込み客を獲得する方法 ―― 検索ボリューム0のクエリが成果を生む
- URLのキーワード効果はごくわずか、区切りはハイフンなど、グーグルがURLの疑問に回答
- robots.txtに絵文字やアスキーアートは書けるか? グーグルが解説する正しい書き方と AIクローラへの対処
- 検索流入より直接の再訪を。メディアがゼロクリックに備えて専門特化型のオーディエンスチーム再編
- Google Business Home登場、GBPや広告などを1つにまとめたGemini搭載の管理ダッシュボード
- 順位チェックツールの数字がおかしい? Google が返す「ニセの検索結果」の影響
- 「GEOは無駄」なのか? AI トラフィックをめぐる 3 つの調査とその反論
今週のピックアップ
メンテ中に503は正しいけど、グーグル推奨は「robots.txtは200」。これは知らなかった!
意外と知られていないガイドライン (SEMリサーチ) 国内情報
メンテナンス時には503を返すこと。ただしrobots.txtは200を返すこと
こんなガイドラインを渡辺隆広氏が紹介し、詳しく解説してくれている。
2026年10月21日夜、PHPの脆弱性対応のため、多くの国内サイトが一斉に緊急メンテナンスに入った。渡辺氏が、その最中に112サイトを調べたところ、トップページでHTTPレスポンスコードとして503を返していたのは61サイトあったが、そのうちrobots.txtを正しく200で返していたのは3サイトしかなかった。
そこで渡辺氏は、グーグルの公式ドキュメントをもとに、メンテナンス中に「必ずやること」「やってはいけないこと」「やっておくと安心なこと」を整理してくれた。
- 200: OK(リクエストが正常に処理された)
- 503: サーバーが一時的にリクエストを処理できない(メンテナンス・過負荷など)
- 403: アクセス禁止(権限不足など)
- 404: Not Found(見つからない)
- 410: Gone(リソースが恒久的に削除され、今後も利用できない)
- 429: リクエストが多すぎる(レート制限超過など)
- 301: 恒久リダイレクト
- 302: 一時リダイレクト
まずはその要点を理解しておこう。
- 必ずやること:
- 全ページで、別のURLへ転送せず元のURLのまま503を返す
- robots.txtは通常どおり200で返す(503は返さない)
- 503を何日も続けない(目安は1日~2日)
- 復旧後、トップページ・主要ページが200に戻ったかを確認する(念のためにrobots.txtも)
- やってはいけないこと:
- メンテナンスページを200で返す(ソフト404扱いになる)
- 403・404・410を返す(404と同じ扱いになり、インデックスから削除される対象になる)
- 302で200のページへ転送する
- サーバーやDNSを止める
- 503の代わりに429を返す
- noindexを使う
- Search Consoleの削除ツールを使う
- やっておくと安心なこと:
- Retry-Afterヘッダーを付ける
- 外部リソースを読み込まない静的なメンテナンスページを用意する
- サイト全体を止めずに一部の機能だけ止められないか検討する
- CDNやロードバランサーなど別の層から503を返す
- 復旧後にSearch Consoleを確認する
robots.txtが503だと何が起こる?
渡辺氏の情報で興味深いのは、「robots.txtへのリクエストでは503を返さず200を返すようにする」原則だ。
渡辺氏の調査でも、メンテナンス状態をちゃんと503で示しているサイトはそれなりにあったが、robots.txtも含めて503にしていたところが多かった。
robots.txtが503だと何が起こるのだろうか?
挙動は503を返している時間によって変わる。最初の12時間はサイト全体のクロールが止まり、その後30日間は、最後に取得できたrobots.txtのキャッシュが使われるのだという。
通常のメンテナンスは数時間で終わるだろうから、ほとんどの場合は実質的には問題になることはない。しかし、渡辺氏が補足している次の点が、この件を改めて解説している理由の1つでもあるだろう。
なお、Search Consoleのクロール統計レポートではrobots.txtの429と5xxは「取得失敗」として数えられ、サイトの可用性警告の原因になります。
せっかく503を設定しているのだから、グーグルが推奨するようにrobots.txtを除外して、グーグルからも適切なメンテ状態だと認識されるようにしておきたいものだ。
ただし、PHPではなくHTTPサーバー自体の脆弱性への対応だったり、robots.txtの出力に動的プログラムを使っていたりする場合は特別な対応が必要になる。わからない場合は技術者と相談しておこう。
メンテ画面や503で知っておくべきその他の知識
渡辺氏は、メンテ表示に関してそれ以外もさまざまな「べし・べからず」を教えてくれている。ここではポイントだけをいくつか紹介しておこう。
停止が長引く場合:
1日~2日を超えるなら503を続けず、中身のあるトップページを200で公開するのがグーグルの推奨である。FAQや問い合わせ先を載せた簡易サイトを公開した札幌市が、その好例として紹介されている。転送型のサイトの直し方:
sorryページのHTMLはそのまま使い、転送をやめて元のURLで503を返すようにする。どうしても転送が残るなら、301ではなく302か307を使い、転送先は503にし、robots.txtは転送の対象から外す。CDNとWAFの注意点:
CloudflareのWAFのブロック応答では400番台しか指定できない(2026年10月時点)。CloudFrontはエラー応答をキャッシュするため、復旧後もしばらく503が残ることがある。共用ホスティングの場合:
「阿部寛のホームページ」は静的サイトにもかかわらず、@nifty側でサービス全体が止まったため503になっていた。メンテナンス時の応答はホスティング会社しだいである。
メンテナンスが短時間で終わるなら、実際の被害はほとんどない。だが、今回うまくできていなかったサイトは、普段のメンテナンスでも同じ設定を使っている可能性が高い。「robots.txtは200、それ以外は503」を基本とし、curl -Iで確認する。この手順を、停止が長引く前に決めておくことが大切だ。
ここでは主要ポイントだけを紹介したが、元記事は渡辺氏が丁寧に解説している。いつ同じような事態が起きるとも限らない。読んでおこう。
ちなみに、SEOのためのメンテ画面表示については、過去にこのコーナーでも紹介している:
懐かしのWeb担編集部ブログでも、2009年に.htaccessファイルの書き方を含めて解説する記事を公開していた:
後者の記事ではrobots.txtが除外されていなかったが、今回の渡辺氏の記事を受けて早速改訂されている。
確認したところ、Web担ではrobots.txtへのリクエストにも503を返すようになっていたが、今回の渡辺氏の記事を受けて実装を追加したとのことだ。
- SEOがんばってる人用(ふつうの人も気にして損なし)
- 技術がわかる人に伝えましょう
グーグル検索SEO情報①
E-E-A-Tに「スコア」は存在しない! 著者情報を足しても順位が上がらない理由
本当に見るべき指標とは (株式会社JADE) 国内情報
E-E-A-Tを高めるには、どうすればいいのだろうか? そもそも、E-E-A-Tとはどんな仕組みなのだろうか。勘違いされがちなE-E-A-Tについて、株式会社JADEが解説してくれた。
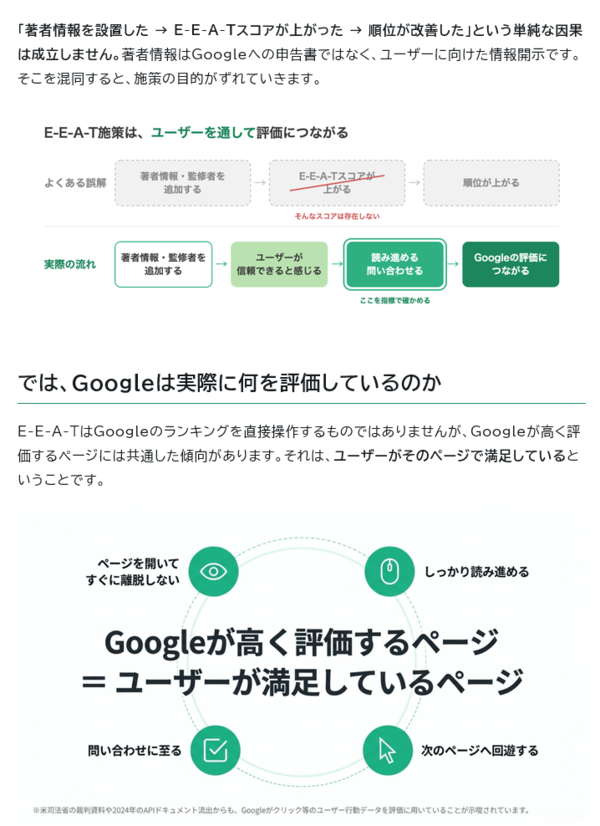
E-E-A-Tを「スコア」だと考えている人は多いが、グーグルは「そういうスコアは存在しない」とはっきり言っている。そのため、著者情報や監修者を付けただけで順位が直接上がるわけではない。E-E-A-T施策の効果は「やったかどうか」ではなく「それによってユーザーの行動が変わったか」で測るべきだと株式会社JADEは主張している。
コアアップデートの後、著者プロフィールを足したり、専門家に監修を頼んだり、運営者情報を整えたりするサイトは多い。それでも「順位が動かない」という相談がよくあるという。JADEによるとその原因は、「何が良くなれば成功なのか」を決めていないことにある。施策の評価が「やったか」で止まっていて、その先を見ていないのだ。
E-E-A-Tは「経験」「専門性」「権威性」「信頼性」の4つからなり、検索品質評価者のためのガイドラインに書かれている考え方の枠組みだ。評価者の判定はアルゴリズム変更の検証に間接的に使われるが、グーグルは評価者の評価がランキングに直接影響することはないと明言している。ゲイリー・イリェーシュ氏も2019年に、「E-E-A-TスコアやYMYLスコアのようなものは社内にない」と話している。
では、グーグルは何を見ているのか。元記事では、「グーグルが高く評価するページには、ユーザーが満足しているという共通点がある」と見ている。すぐに離脱せず、読み進めて、次のページへ移り、問い合わせにつながる、といった行動だ。根拠として、米司法省の裁判資料や2024年のAPIドキュメント流出から、グーグルがクリックなどの行動データを使っていることがうかがえる点を挙げている。
著者情報などの施策を否定しているわけではない。こうした情報はユーザーが「信頼できる」と感じる材料になり、その結果として行動の改善につながる。だからこそ、効果は「ページに著者情報を入れたか」ではなく、「著者情報を入れたことでユーザー行動がどう変わったか」の指標で確かめる必要がある。具体的には、次のような指標が考えられる:
- 熟読率
- スクロール
- 滞在時間
- 監修者紹介ページへの移動
- 直帰率やコンバージョン率の変化
- 分野と組み合わせた指名検索の増加
E-E-A-Tは「作業で上げるスコア」ではなく、「ユーザーに安心して読んでもらうための品質の基準」だ。著者情報を付けて終わりにせず、ユーザー行動のKPIで効果を確かめることが大切だし、施策内容もそうした変化に影響を与えるものとして設計する必要がある。
- SEOがんばってる人用(ふつうの人は気にしなくていい)
サイトマップ、まだ必要? グーグルが語る今も役立つ理由とよくある誤解
コンテンツ品質が低いと無視されることも (Search Off the Record) 海外情報
サイトマップ(人間向けではなく検索エンジン向けのもの)は、今の時代でも出しておくほうがいいのだろうか?
グーグル検索のポッドキャスト「Search Off the Record」第114回で、マーティン・スプリット氏とジョン・ミューラー氏が解説した。
主要ポイントは次のとおりだ:
サイトマップは約20年前に誕生し、グーグル、マイクロソフト、ヤフーが合意した仕様である。当初の目的は「構造が複雑でクロールしにくいサイトのURLを検索エンジンが発見しやすくすること」だった。
グーグルは
priorityとchangefreqの使用をやめた。サイトマップ上で全ページを「最優先」や「常時更新」とするサイトが増えたことが原因。動的なページでは技術的には「常時更新」が正しいのだが、グーグルの観点ではその情報が役立つとは限らない。筆者補足: サイトマップの仕様から両項目が廃止されたという意味ではない。公式ドキュメントでは、グーグルは両項目の値を無視すると説明している。グーグルが主に使うのは「URL」と「最終更新日」(
lastmod)である。lastmodには最後に重要な変更をした日時を入れるべきだ。全URLに当日の日付を入れるなど日付が信頼できない場合、グーグルは日付よりも新しいURLの検出などを重視する。ただし、それ自体をスパム扱いするわけではない。小規模サイトには必須ではないが、多くのCMSが初期設定で生成するため、ミューラー氏は有効のままにしておくことを勧めている。小規模サイトでもサイトマップを用意することに害はないという。
ニュースサイトや価格が変わるECサイトなど、一定量のコンテンツがあり、定期的に更新されるサイトでは特に有用である。ミューラー氏は、ニュースサイトマップについて「直近に変更された1,000ページを載せるものだったと思う」と説明した。
筆者補足:公式ドキュメントに基づくと、正確な要件は、「過去2日以内に公開された記事を対象とし、1ファイル内の<news:news>タグを最大1,000件とする」ことである。1,000件を超える場合は複数のファイルに分割できる。サイトマップにはインデックスさせたい正規URLを載せる。トラッキング用パラメータや一時的なタイムスタンプ付きのURLは避ける。サイトマップへの掲載は正規URLの選択にも使われ、類似URLの中からそのURLが選ばれる可能性を少し高める。
RSSフィードは「URLの発見」と「更新日時の認識」という点でサイトマップと似た働きをするため、Search Consoleでサイトマップとして送信できる。最近更新されたURLに絞って確認できることが利点である。
サイトマップにはいくつかの制限がある。
- 1ファイルの上限は50,000URL
- 1ファイルあたり非圧縮で50MBまで
- 複数のサイトマップファイルはサイトマップインデックスでまとめられるが、サイトマップインデックスのなかにサイトマップインデックスは含められない(入れ子は1階層のみ)
ただし、Search Consoleにはサイトマップやサイトマップインデックスを送信する数に制限はない。
※筆者補足 公式ドキュメントに基づくと、サイトマップインデックスから別のサイトマップインデックスを参照することはできない。また、Search Consoleの各サイトで送信できるサイトマップインデックスは最大500ファイルとされているため、「送信数に上限はない」とするポッドキャスト内の説明には注意が必要(現実的には問題ないはずだが)。
サイトマップはrobots.txtに記載するか、Search Consoleで送信できる。サイトマップが存在することを広く知らせたくない場合は、独自のファイル名にしてrobots.txtには記載せず、Search Consoleでグーグルに直接知らせる方法もある。ただしその場合、Bingなどへの個別送信が必要になり、AIクローラも発見しにくくなる可能性がある点には注意が必要。
ミューラー氏は、自身のサーバーログで一部のAIクローラがサイトマップやRSSにアクセスするのを見たことがあると述べている。
HTMLで作ったサイトマップはユーザー向けのナビゲーションページであり、検索エンジン用のサイトマップとは別である。リンク集としてクロールの助けにはなるが、XMLサイトマップと同じように送信・処理することはできない。
llms.txtはHTMLサイトマップに似たリンクを含むMarkdownファイルだが、現時点でグーグルのシステムではサイトマップとして使えない。
ミューラー氏は「将来への期待に頼るのではなく、現在実際に機能し、文書化されている方法に注力すべき」だと述べている(つまり、llms.txtは不要だと言っている)。CMSが自動生成する場合や実験的に設置してみることは構わないが、サイトマップを利用せずにllms.txtだけにしたり、他のことよりもllms.txtを優先したりするべきではないという。
有効で公開アクセス可能なサイトマップでも、「取得できませんでした」と表示される場合がある。ミューラー氏は、その理由としてホストの負荷に応じたクロールの制約と、クロール需要の低さを挙げた。サイトの品質に対するグーグルの評価がクロール需要に影響し、サイトマップの取得を見送る場合もあるという。
※筆者補足 品質評価が影響する場合もあるという説明であり、「取得できませんでした」の原因がサイトの品質が低いことに常によるとは限らない。サイトマップは
hreflang、画像、動画にも対応する。ページ上の画像や動画を認識しやすくなったため、画像・動画サイトマップが現在どれほど重要かはわからないとミューラー氏は述べている。ただし重要性が低下したと断定したわけではなく、引き続きサポートされている。
XMLサイトマップは、特にコンテンツ量が多く、定期的に更新されるサイトで今も有用だ。正規URLと、正確なlastmodを記載することが重要である。「取得できませんでした」には、技術的な問題だけでなく、クロール需要やサイトの品質に対するグーグルの評価も影響する場合があると理解しておくべきだ。
ちなみに、この回の文字起こしはtranscriptのページからPDFとしてダウンロードできる。
- SEOがんばってる人用(ふつうの人は気にしなくていい)
「JPEG XL」と「AVIF」、ウェブで写真を使うならどっち? 世界的なWeb開発者が徹底比較
多くの用途でAVIFが優位、JPEG XLはロスレスとJPEG変換で強み (JakeArchibald.com) 海外情報
JPEG XL(.jxl)は、「JPEGの完全な後継」として開発された次世代の画像フォーマットだ。高い圧縮率と画質を両立するだけでなく、「過去のJPEG資産を無劣化で小さくできる」というWebPやAVIFを含む他の画像形式にはない独自の強みを持っている。
JPEG XLが主要ブラウザすべてに実装されたことを受け、Webで使う場合のJPEG XLとAVIFの優劣をジェイク・アーチボルド氏が比較した。
筆者補足:ジェイク・アーチボルド(Jake Archibald)氏は、Web標準の策定・ブラウザのパフォーマンス・開発者向け広報(Developer Relations)の分野で広く知られるイギリス出身の著名なWeb開発者・エンジニア。現在はMozillaに所属しているが、長年グーグルのChromeデベロッパーリレーションズチームに在籍し、Web標準の仕様策定や新しいブラウザ機能(Service WorkerやView Transitionsなど)の実装・普及に貢献してきた。
紹介するのは2026年10月15日公開の記事で、複数の画像処理プログラムを使って測定している。比べているのは形式の理論上の限界ではなく、記事時点の実装と、アーチボルド氏が選んだ画像での検証だ。
実験で利用したプログラム・ライブラリとバージョンは次のとおり:
- avifenc 1.4.2
- libjxl 0.12.0(cjxl encoder)
- jixel 0.4.2
- cwebp 1.6.0(比較用)
結果としては、多くの用途でAVIFが総合的に優位だった:
写真では、同程度の画質なら多くの場合AVIFのほうが小さいファイルサイズになった。デフォルトの処理レベルでは、最も小さいJPEG XLでも通常15%〜25%大きく、最大の処理レベルにしても通常6%〜20%の差が残る。ただし例外もあり、「イタチ」の写真ではJPEG XLのほうが小さくなった。
スクリーンショットとイラストでは、差が大きかった。JPEG XLはデフォルトの処理レベルで30%〜90%、最大の処理レベルでも20%〜70%大きかった。通常はPNGを使っていたような画像でも、ピクセル単位で一致する必要がなければ非可逆のAVIFで十分だとアーチボルド氏は述べている。
透過のある画像でもAVIFが有利で、JPEG XLではプログラムによっては31%〜70%大きく、透過部分を常にロスレスで保存するプログラムではAVIFの約2〜3倍のサイズになった。
JPEG XLのエンコーダでは、jixelのほうがlibjxlよりファイルサイズが小さくなることが多い。ただし、「品質指標のスコアは良いのに見た目は明らかに劣る」ケースもあった。処理レベルを上げる価値があるのはAVIFとjixelだった。libjxlでは処理レベルを上げても時間とメモリが増えるわりに効果が小さく、かえってファイルサイズが大きくなることもある。
ファイルサイズも考慮に入れると、速度とメモリでもAVIFが総じて有利だ。デコードは中品質でJPEG XLが通常2倍〜3倍の時間がかかる。ただし非常に高い品質では差が縮まり、ChromeではJPEG XLのほうが速いこともある。
一方、JPEG XLにも強みがある。既存のJPEGを変換すると、画質を落とさずに9%〜20%小さくなった。ロスレス圧縮でもサイズ面で優位で、写真ではロスレスWebPが9%〜17%、ロスレスAVIFが40%〜96%大きかった。ゲインマップを使わないHDR画像でもJPEG XLのほうが小さくなる傾向があった。
ただし2つの品質指標の評価は大きく食い違っている。またJPEG XLのゲインマップにはブラウザが対応しておらず、アーチボルド氏はこれを弱点としている。
プログレッシブ表示(段階的に読み込むフォーマット)に対応しているブラウザは、JPEG XLはChromeとFirefox、AVIFはChromeのみだ(記事時点)。AVIFはプレビューの見せ方を細かく決められ、今回の比較では多くの場合ファイルが小さく、デコードも速かった。JPEG XLの読み込み途中の画像は「ピントの合っていない完成画像」に見えかねないともアーチボルド氏は指摘している。
アニメーションについては、アーチボルド氏は動画形式を使うべきだとしている。
現時点の王道はAVIFの最高画質モード
アーチボルド氏が現時点でWeb用の第一候補にしているのは、許容できる範囲で処理レベルを上げたAVIF 4:4:4※だ。AVIFのファイルが異常に大きいと感じたときだけ、jixelでJPEG XLも試すという。
※筆者補足 AVIF 4:4:4とはAVIF画像の最高画質モードで、色の情報を間引かずに保存し、文字や細い線の色にじみを抑える指定。ただし色情報を間引いていない分、通常のAVIF(4:2:0)に比べるとファイルサイズは増加する。
もっとも、どちらの形式も実装が大きく改善しているため、AIの回答も含めて他人の主張をうのみにせず、自分の画像で比べるようアーチボルド氏は勧めている。
なお、グーグル検索がサポートする画像フォーマットにJPEG XLは含まれていないが実際には問題なくインデックスされている。ドキュメントが更新されていないだけかもしれない。
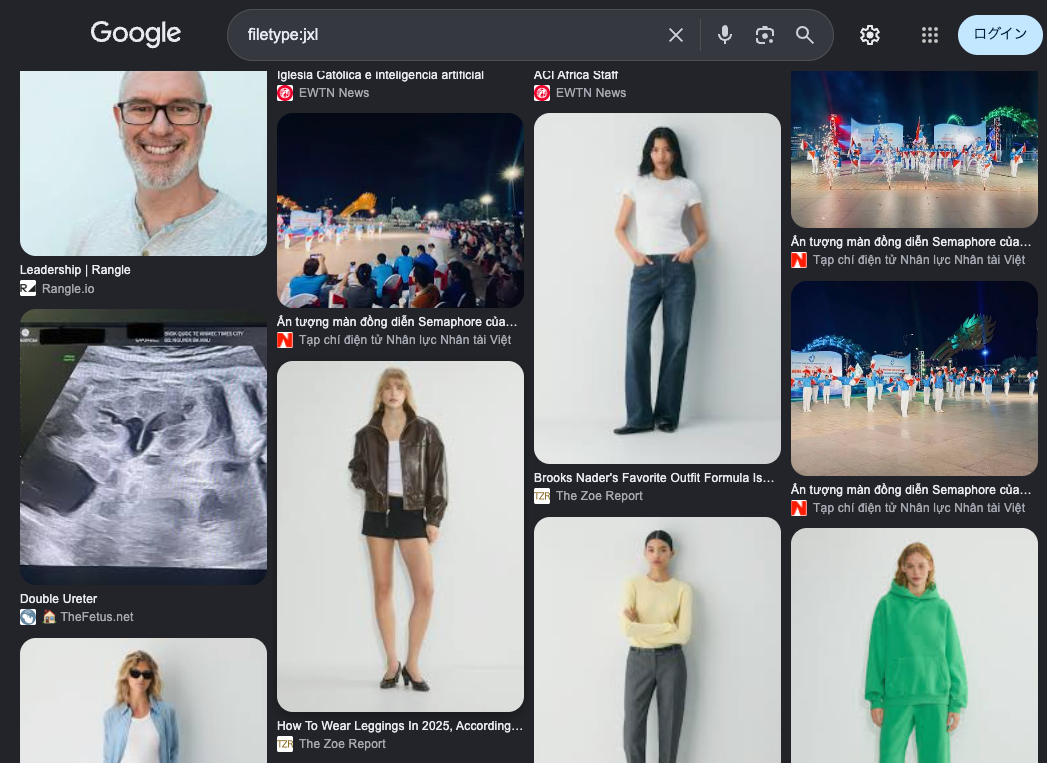
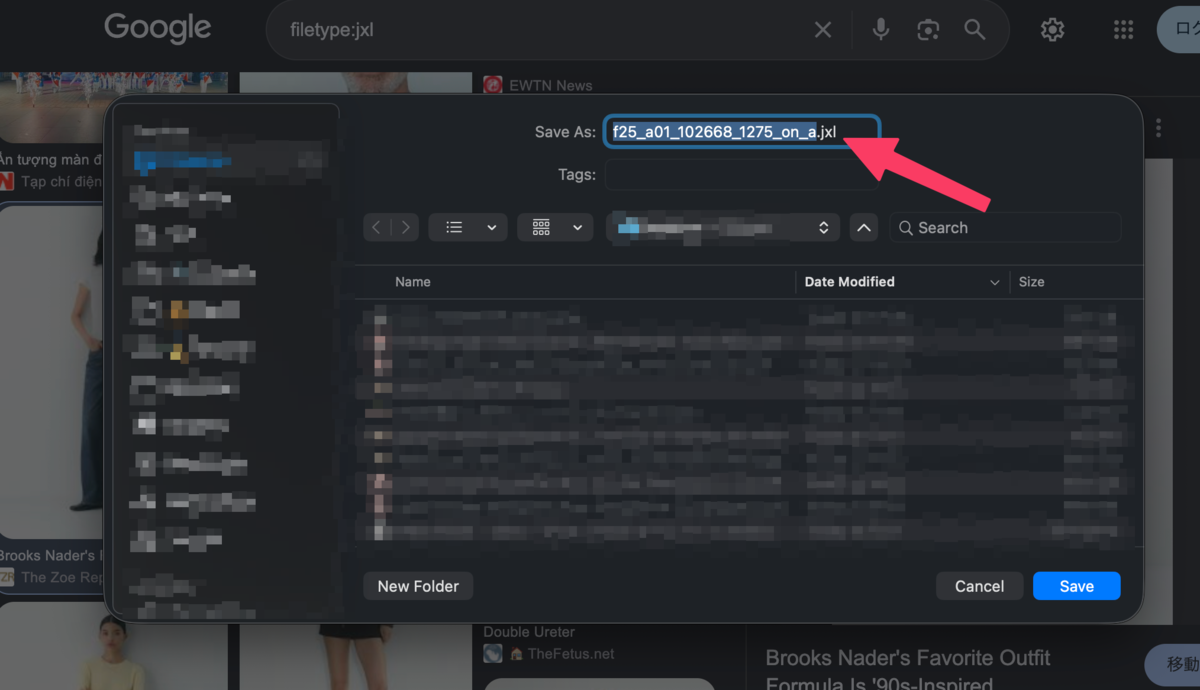
.jxlになっている- パフォーマンス改善がんばってる人用(ふつうの人は気にしなくていい)
- 技術がわかる人に伝えましょう
トップページの5倍の表示回数、AIOで最も引用されたのは会社概要ページだった!?
「人間向けコンテンツ」こそ最良のGEO (Lily Ray in LinkedIn) 海外情報
ある大手ブランドのサイトで、グーグルのAI OverviewsとAI Modeに最も多く引用されていたのは、ごく普通の会社概要(About)ページだった。
リリー・レイ氏が、同サイトのグーグルSearch ConsoleのAIパフォーマンスレポートで確認したそうだ。表示回数はトップページの実に5倍に達していた。
このページは、LLMやAIエージェント向けに作られた特別なものではない。会社の歴史や変化を詳しくまとめた、人間向けのページだ。見た目もよく、人にもAIにも理解しやすい形で書かれている。
この事例からレイ氏が導いた教訓はシンプルだ。
詳しく正確なAboutページを作れ
これは何年も前から、特に2017年にE-A-T(現在はE-E-A-T)が注目されて以降、SEO業界でずっと推奨されてきたことでもある。
一方で、レイ氏はLLM専用ページの作成には強く慎重な立場をとる。
グーグルもOpenAIもアンソロピックも、「LLM専用版のコンテンツやMarkdownの用意」をサイト運営者に求めていない。その背景として考えられる1つの理由に、「LLM専用ページは悪用しやすい」点があるのは間違いないだろう。「プロンプトを仕込む」「内容を誇張する」「実際のユーザーには見せない宣伝情報をAIに与える」といった操作の温床になりうる。
そのため、AI企業がいずれこうしたページを無視したり、評価を下げたり、信頼できないものとして扱ったりするようになるとレイ氏は予測している。影響がページ単体にとどまらない可能性もあるという。人間向けページとまったく同じ内容を善意で載せているだけの企業でも、取り締まりの巻き添えになりかねない。
考えてみれば、人間向けのページと照らし合わせて内容を確認するのならば、そもそもLLM専用ページは意味がないということだ。
AI向けの特別なコンテンツに費やす時間と労力を、人間向けの情報の充実に回すべきだとレイ氏は強調する。会社の「歴史」「専門性」「人材」「製品」「評判」を、人間が見つけやすく、理解しやすく、確かめやすい形で示す。それだけでAIも必要な情報を得られる。現在のAIの仕組みの隙を突く手法と違い、AI側が締め付けを強めたときに足かせになる心配もない。
- GEOがんばってる人用(ふつうの人は気にしなくていい)
- この記事のキーワード
関連記事

Webサイトのメンテナンス中画面を出す正しい作法と.htaccessの書き方
2009年6月16日 11:00

出典の明記はグーグルのE-E-A-Tを高める効果あり!? スタンフォード大学も言ってるし【SEO情報まとめ】
2023年5月12日 7:00

ヤフーの検索結果は広告だらけ!? オーガニック検索はどこへ行った? など10+4記事
2014年7月25日 9:00

グーグル検索結果CTR調査【最新版】―― 1位CTRは19%~38%と業界格差が拡大【SEO情報まとめ】
2025年3月21日 7:00

グーグル検索のトップが交代、新トップは収益増加よりもUX改善を優先?【SEO情報まとめ】
2024年10月25日 7:00

あなたも同じミスをするかも? robots.txtのミスで予想外のページをクロール禁止していた悲劇【SEO情報まとめ】
2022年11月4日 7:00
バックナンバー


この記事の筆者

筆者の人気記事

「別タブで開く」リンク(target="_blank")は脆弱性あり?【SEO情報まとめ】
2020年3月13日 7:00

【重要】コアウェブバイタルとは? LCP/FID/CLSをわかりやすく解説【SEO情報まとめ】
2020年6月5日 7:00

新人に読ませておきたい「グーグルSEOでやったら本当にヤバいこと」【SEO記事12本まとめ】
2018年4月13日 7:00

グーグルが公式SEOチェックツールを公開【SEO記事11本まとめ】
2018年2月9日 7:00

もう待ったなし! グーグルが全サイトをMFIに強制移行へ(2020年9月予定)【SEO情報まとめ】
2020年3月27日 7:00

モバイルの「続きを読む」ボタンにグーグルの主要メンバーが不快感、将来は検索で不利になるのか?【SEO記事12本まとめ】
2017年2月10日 7:00