競合に気づかれずに見込み客を獲得する方法 ―― 検索ボリューム0のクエリが成果を生む
グーグル検索SEO情報②
競合に気づかれずに見込み客を獲得する方法 ―― 検索ボリューム0のクエリが成果を生む
SEOツールが見逃す隠れた商用クエリ (DEJAN) 海外情報
「競合に注目されにくい形で見込み客を獲得する方法」を、SEOコンサルタント企業DEJAN(デジャン)のダン・ペトロヴィッチ氏が提案している。そのポイントは「一般的なSEOツールに検索ボリュームが記録されていない商用クエリ」を狙うという手法だ。
一般的なSEOツールは、記録済みの検索ボリュームと順位からトラフィックを推定する。「検索ボリュームが大きいことがツールでわかっているクエリ」は、同業界の競合他社も狙おうとするだろう。いまそのクエリでトラフィックを得ていても、いつ競合にトラフィックを奪われるか、わからない。
しかし考え方を変えると、「SEOツールが把握していないクエリ」から流入を得られれば、どうやってトラフィックを獲得しているのか競合は見つけられず、そうしたクエリを横取りされないというわけだ。その背景にあるのは、「ツール上の検索ボリュームがゼロでも、実際の検索需要がゼロとは限らない」という点だ。
具体的な例として、「ある学術論文のタイトル」をペトロヴィッチ氏は挙げている。キーワード調査ツールではそのクエリのトラフィック見積もりはゼロだった。しかし実際には、そのクエリでトラフィックが発生していた:
- SEOツールのトラフィック見積もり: 0/月
- 実際のSearch Consoleの数字(6月):
- 表示: 1020回
- クリック: 37回
- 平均掲載順位: 4.3位
- クリック率: 3.6%
AI Overviewsやチャットの回答にも表示されたという。
しかも37クリックは1つのクエリ表現だけの数字で、タイトルの別表現や一部分での検索を合わせれば流入はさらに増える。この例で言うと、「話題になり始めた研究やデータをいち早く取り上げ、競合がいないうちに露出を得る戦術」をペトロヴィッチ氏は勧めている。
ただし、この事例は特定の層にブランドを知ってもらう間接的な例という位置づけだ。
顧客の生の言葉はどこにあるか
さらにビジネスに近づけるための手法として、「顧客が実際に使う表現」を拾える情報源を、ペトロヴィッチ氏は紹介してくれた。次のようなものだ:
自社が持っているログデータ:
- サイト内検索ログ
- サポート記録
- チャットボットのセッション
顧客の発言:
見積もり依頼やCRMのメモから情報を拾う。その際には「暖房修理」のような全般的な表現を気にするのではなく、「5分で暖房が止まる」といった具体的な表現を拾い、成約案件とひも付けて購買意図のある言葉を見極めていく。
顧客の質問:
営業通話、リードフォーム、購入や予約の直前に顧客がする質問などから、同様に特有のニーズやペインやコンテキストをもった表現を拾う。
オンライン:
- Reddit(レディット)
- Telegram(テレグラム)
- YouTubeのコメント
- レビュー欄
ローカル:
地元の人との会話から見つかる地域特有の言い回しも、忘れてはいけない。
キーワードデータベースに頼らない方法としては、次のような手段がある:
- 購入者インタビュー
- 覆面調査
- 購入時点からさかのぼるジャーニーマッピング
- グーグルのMessy Middleフレームワークを使った言語モデルへの質問※Messy Middle(メッシー・ミドル)とは、消費者が「買いたい」と思ってから購入を決めるまで、情報収集と比較・検討を何度も行き来する過程のこと
- ジョブ理論(Jobs-to-be-done)に基づく文章化
「多数の除外キーワードを設定したグーグル広告のインテントマッチで、コンバージョンにつながる未把握のクエリを探す」方法も挙げられている。
もちろん「AIで候補を生成する」手法にも触れている。エンベディング空間の探索で候補を作っているが、結果は確率的なものにすぎず、人間が実際に使う表現かどうかは別途確かめる必要があるという。
ほかの実務家の手法として、次のようなものも紹介されている:
- 業界固有の語彙リストとエンティティのギャップ分析
- BERTによる競合クエリの抽出
- 複数地域での「他の人はこちらも質問」の収集
体系化に向けた5段階のワークフロー
これまでのサイト内検索データの使い方が、「関連クエリの出現頻度が任意の基準を超えたら記事を書く」という場当たり的なものだったとペトロヴィッチ氏は認めている。そのうえで、次の流れを提案している:
- サイト内検索や顧客対応などから、生のクエリを集める
- ノイズを除き、言語モデルで意図を「商用」「問題解決」に分類する
- 似た表現を代表的なトピックにまとめ、ターゲットの重複を避ける
- 「トピック」「ユーザーの課題」「自社の提供物」の関係をエンティティグラフにする
- その関係をもとに、コンテンツと内部リンクを設計する
要は、検索ボリュームの推定値だけでクエリの価値を判断せず、自社データやコミュニティから顧客の生の言葉を拾うべきだということだ。
これは単なる「SEOテクニック」ではない。「潜在顧客を理解し、適切な接点を探る」手法であり、マーケティングの根本だとも言える。
日本では以前から「掲示板やQ&Aサイトから顧客が実際に書き込んでいる悩みや表現を見つける」手法がSEOで利用されていたが、その発展形だとも言えるかもしれない。
- SEOがんばってる人用(ふつうの人は気にしなくていい)
URLのキーワード効果はごくわずか、区切りはハイフンなど、グーグルがURLの疑問に回答
ドメイン名に絵文字はNG、パスならOKだが推奨せず (The Non-Canonical Cabinet on YouTube) 海外情報
グーグル検索セントラルのYouTubeチャンネルが、新シリーズ「The Non-Canonical Cabinet」を始めた。検索チームのゲイリー・イリェーシュ氏とチェリー・プロマウィン氏が、通常のFAQには載らないSEOの珍しい疑問に答えるシリーズだ。
第1回のテーマは、「ドメイン名とURLパスにどんな文字を使えるのか、そして使うべきなのか」だ。
主なポイントをまとめる。
まずドメイン名だ。ルールを決めているのはグーグルではなく、ICANNとIETFの標準規格(RFC1035とRFC1123)で、グーグルもそれに従っている。使えるのはA〜Zの英字、数字、ハイフンが基本だ。
中国語やアラビア語などを使う国際化ドメイン名(IDN)も使える。裏側では「xn--」で始まるPunycodeに変換されるが、ブラウザのUI上では通常、それぞれの言語の文字で表示される。地域に根ざしたビジネスならブランド認知に役立つ。ただし、英語の「p」にそっくりなキリル文字の「р」のような紛らわしい文字は、人もブラウザも混乱させるので避けたほうがいい。
一方、絵文字はドメイン名には使えない。標準規格が認めていないからだ。そもそも、つづりがわからないドメイン名は入力も検索もしてもらえない。
ドメイン名やURLに検索キーワードを入れる効果については、ランキング要因としてはごく小さい。意味を持つのはコンテンツがまったくない新しいページのように、ほかに判断材料がほとんどない場合だけだ。ページにコンテンツが入れば、ほぼ関係なくなる。
URLパスはドメイン名よりも自由がきく。
※Web担編注 「URLパス」は、URLのホスト名の後の部分:
- URL:
https://example.com/blog/seo-tech/?t=1- パス:
/blog/seo-tech/URLの標準規格STD66のもとで、絵文字や英語以外の文字を含むUTF-8の文字を使え、Googlebotもクロールして処理できる。ドメイン名がPunycodeを使うのに対し、パスはブラウザが「パーセントエンコーディング」で変換する。
※Web担編注 例:
- パーセントエンコード済みURLパス:
/blog/Web%E6%8B%85%E5%BD%93%E8%80%85- ブラウザでの表示URLパス:
/blog/Web担当者パーセントエンコーディングの問題点は生状態の読みやすさ(読みにくさ)だ。ブラウザやSNSアプリによっては、エンコードされたパスが意味不明な文字列として表示され、クリックをためらわせてしまう。シンプルでわかりやすいURLは信頼につながる。単語を並べても、文章のようなURLにしてもかまわない。
単語の区切りには、アンダースコア(_)ではなくハイフン(-)を使うのがよい。その理由は、グーグルはURLパス内で「アンダースコアでつないだ単語を1つの長い単語として扱う」からだ。
※Web担編注 グーグルは「seo-service」は「seo」と「service」の2単語に分割して解釈するが、「seo_service」は「seo_service」という1つの単語として扱う。ハイフンはウェブ全体で通用する区切りで、システムにも人にも読みやすい。なお、ドメイン名ではそもそもアンダースコアは使えない。
動画はドラマ形式というかコント形式というかアニメっぽいというか、なんとも言えないスタイルだが、個人的にはよくできていておもしろいと感じた。イリェーシュ氏とプロマウィン氏がどちらも独特のキャラクターを演じており、視聴者を飽きさせずにトピックを理解できるように工夫してある。
この記事で読むだけでなく、ぜひ本家の動画を通して見てみてほしい(動画では、自動翻訳だが日本語字幕も利用できる。歯車アイコンから設定可能)。
- SEOがんばってる人用(ふつうの人は気にしなくていい)
robots.txtに絵文字やアスキーアートは書けるか? グーグルが解説する正しい書き方と AIクローラへの対処
robots.txt仕様の基本と落とし穴 (The Non-Canonical Cabinet on YouTube) 海外情報
グーグル検索チームのゲイリー・イリェーシュ氏とチェリー・プロマウィン氏による動画シリーズ「The Non-Canonical Cabinet」の第2回は、robots.txtがテーマだ。
どこまで装飾できるか、絵文字や英語以外の文字を使えるか、AIによるコンテンツ利用を制御できるか、といった一風変わった質問に答えている。
robots.txtはサイトのルートディレクトリに置くプレーンテキストのファイルだ。検索エンジンやAI学習用のクローラなど、(ルールを守るつもりのある)クローラに対して、「サイトのどこにアクセスしてよいか・いけないか」を伝える。ルールはインターネット標準のRFC9309で定められており、グーグルもこれに従っている。
「#」で始まる行はコメントとして無視されるので、アスキーアートを入れること自体は技術的に可能だ。記述の97%が装飾で、ルールは3%しかないサイトの例もある。パーサー(読み取り機)は壊れなかったが、帯域の無駄にはなっていた。
注意すべきは、robots.txtの読み込みで認識するのは4つの指示(トークン)だけだという点だ(パーサーは理解できない行を黙って捨てる):
user-agentallowdisallowsitemapuser-agentトークン(クローラを識別する名前)に使えるのは、英字とダッシュだけだ。絵文字や英語以外の文字は使えない。
URLパスに「ウムラウト」「漢字」「絵文字」「アラビア文字」などが含まれる場合、グーグルのパーサーはパーセントエンコード(%XX形式)に自動で変換する。しかし、ほかのクローラや古いクローラは変換しないことがある。そのため、ルールにはエンコード済みの形で書くよう推奨している。そうしないと、
disallowの行ごと無視されるおそれがある。AIとの関係で押さえておきたいのは、robots.txtが制御するのは「クロールしてよいかどうか」だけだということだ。「データをAIの学習に使うかどうか」など、その後の扱いまではrobots.txtでは制御できない。特定のAIクローラを締め出したいなら、そのuser-agentトークンを名指しで指定する必要がある。「no-AI-chicken-diary」のような独自ルールを書いても捨てられるだけだ。
結局のところ、robots.txtは「退屈なほど標準どおり」に書くのがよい。RFC9309に従い、使うのは4つの標準ルールだけにして、ASCII以外の文字を含むパスはパーセントエンコードする。
こちらの動画もキャラクターと展開を工夫したおもしろいものになっている。ぜひ字幕を有効にして全体を見てみてほしい。
- ホントにSEOを極めたい人だけ
検索流入より直接の再訪を。メディアがゼロクリックに備えて専門特化型のオーディエンスチーム再編
検索流入に頼らず固定読者を育てる方針へ (Digiday) 海外情報
オンラインメディアの大手のなかに、ゼロクリック検索の時代に備えて、本格的に「検索流入」よりも「ファン育成」に舵を切るところが出てきた。
The Verge
Vox Media(ヴォックス メディア)傘下のテック系メディアThe Verge(ザ・ヴァージ)が、「Google Zero」、いわゆるゼロクリック検索に備えてオーディエンスチームを再編した。「検索流入やページビューを増やすこと」よりも、たまたま訪れた読者をサイトに直接戻ってくる「固定読者に育てる」ことを重視する方針に切り替えたのだ。検索やAIをめぐる環境が変わるなか、外部からの流入に頼るモデルから抜け出そうとしている。
オーディエンス・サブスクリプション担当ディレクターのエスター・コーエン氏は、Digiday Publishing Summitで、「この2年間にチームをジェネラリスト中心から専門特化型へ移行した」と説明した。以前は、コンテンツストラテジストやソーシャルメディア担当が幅広い業務を受け持っていた。現在は次の人材を配置している:
- ニュースレター担当 ―― 新規読者の獲得と、メールを通じた読者との関係づくり
- プラットフォーム・コミュニティ担当(2名) ―― 外部プラットフォームやコミュニティでのエンゲージメント
- ニュースルームアナリスト ―― 編集部と連携し、記事や見出しへの反応を分析する。「匿名ユーザー」「登録ユーザー」「有料購読者」がそれぞれどのコンテンツを読んでいるかも調べる
USA Today(USAトゥデイ)も検索環境の変化に合わせて組織を再編したが、人員削減を伴う動きだった。The Vergeのオーディエンスチームはこの2年で拡大している。ただし、人数や増えた規模は公表していない。
評価方法も変えた。これまでは主にページビューで成果を測っていたが、今はメンバー一人ひとりに個別の成長目標を設定している。具体的な目標や指標は明らかにされていない。
施策の進め方については、次のように解説している:
施策は、「匿名の訪問者」「登録ユーザー」「有料購読者」の3層に分けて組み立てている。
匿名の訪問者にはトップページへの再訪を促す。パーソナライズされたフィードやコミュニティ機能で登録につなげ、限定コンテンツや特典で購読を続けてもらう。
規模を追うよりも、それぞれの段階の読者に「また来る理由」を用意することを目指している。
コーエン氏によると、新規購読者の半数以上は、購読申し込みページへ直接たどり着く読者だという。ただし、その割合は月によって変わる。The Vergeは2024年12月に、有料購読と、閲覧本数に応じて制限をかける動的なペイウォールを導入した。購読者数や購読事業の売上は公表していない。
有料広告やパフォーマンスマーケティングについては慎重に試している段階だ。コーエン氏は、その理由について次のように述べている:
長く付き合える読者を求めるなら、パフォーマンスマーケティングに多額の広告費をかけても、ほかの施策と同様に求める層の読者が集まるとは限らない。そのため、予算の使い道と投資対効果を重視している。
自社サイトやポッドキャストでの告知といった従来型の宣伝にも力を入れている。スクープや独自記事を出したときには、大手ニュースメディアに取り上げてもらうよう働きかけている。
オーディエンス開発やマーケティングの専門家も、この方針を評価している。Twenty-First Digital(トゥエンティ・ファースト デジタル)の創業者兼CEOであるメリッサ・チャウニング氏だ。
同氏は次のように述べている:
オーディエンスチームの役割は、「リーチやページビューを増やすこと」から、「ニュースレター・会員制度・有料購読を通じて読者と直接つながること」へ移りつつある。そのため、チャネルごと、読者との関係の段階ごとに深い専門性が必要になる。
このように、The Vergeは、
- チームの拡大と専門化
- 読者層ごとの施策
- 担当者別の成長目標
を組み合わせ、「読者と直接つながる関係を築くこと」に力を注いでいる。外部からの流入への依存を減らすための取り組みだ。
大きな組織でないと、The Vergeの変革をすべて真似するのは難しいだろう。それでも、検索流入より直接の再訪を重視する方針に重心を移すのは、AIによってさらにクリックを奪われる時代では有効な対抗策に思える。
- すべてのWeb担当者 必見!
Google Business Home登場、GBPや広告などを1つにまとめたGemini搭載の管理ダッシュボード
GBPの管理画面が新機能で復活 (Business Home Help) 海外情報
グーグルは、
- グーグル ビジネスプロフィール
- マーチャントセンター
- YouTube
- グーグル広告
を1つにまとめた管理画面「Google Business Home(グーグル ビジネス ホーム)」のクローズドベータを始めた。
Geminiモデルで動き、「ローカルビジネスのコンテンツ作成」や「店舗や口コミの管理」「成長のための提案」を手助けするのだという。これまでグーグルはビジネスプロフィールの管理を検索結果上にほぼ移していたが、改めて専用の管理画面が復活した形だ。
ヘルプ記事によると、今使える主な機能は次のとおりだ:
- AIによるコンテンツ作成と写真編集
- 営業時間の更新や口コミへの返信などの店舗管理
- ビジネス全体のデータに基づく、優先順位付きの成長アドバイス
- RCS for Businessを使った、AIによる顧客対応メッセージ
今後は、連携したサービス全体をまたいで、「分析」と「次にやるべきこと」を提案するようになる。たとえば、次のような例をグーグルは挙げている:
需要が急に伸びたのを検知して、季節限定のオファーをソーシャルメディアに出す手助けをする。
残念ながら現時点ではGoogle Business Homeを使えるのは、米国と英国の一部の業種だけだ。対象のビジネスには招待メールが届く。利用には次のような条件が含まれる:
- 確認済みのビジネスプロフィールで店舗数が10未満であること
- 1つのアカウントで扱う業種が1つだけであること
- YouTubeチャンネル、広告アカウント、マーチャントセンターのアカウントはそれぞれ1つまでしか連携できないこと
Search Engine Roundtableのバリー・シュワルツ氏は、招待を受けて実際の画面を公開している。ここ数か月で少しずつ展開されてきたようだと見ている。
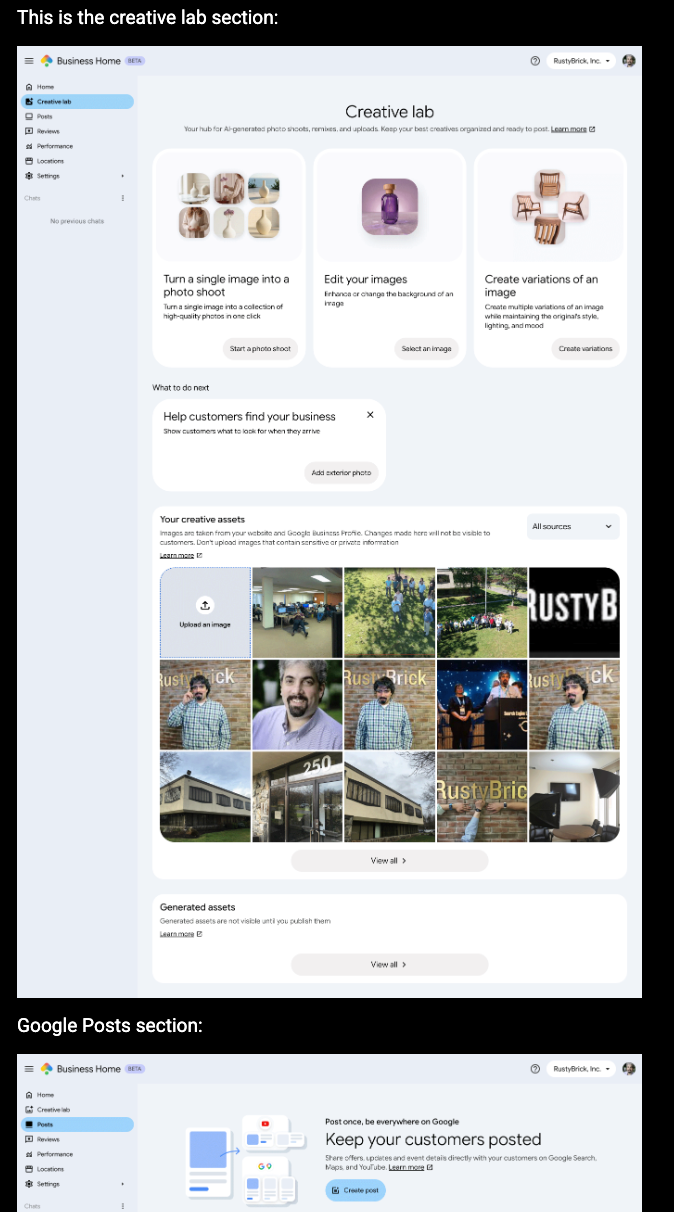
また、ローカルSEOの専門家であるダレン・ショウ氏は、自社の口コミについてGeminiに質問できる点などを高く評価している。ただし、自分ではまだ試していないそうだ。
まとめると、Google Business Homeは、グーグルの主なローカルビジネス向けツールをGeminiで動く1つの管理画面にまとめる試みだ。中小企業の運用を楽にする可能性はあるものの、まだ初期の限定ベータであり、AI機能が広く使われたときにどこまで役立つかはまだわからない。
- ローカルSEOがんばってる人用(ふつうの人は気にしなくていい)
 海外SEO情報ブログの
掲載記事からピックアップ
検索結果のランキングとクリックの計測に関係する記事を2本ピックアップ
- 順位チェックツールの数字がおかしい? Google が返す「ニセの検索結果」の影響
人間のユーザーとは異なる検索結果が返されている!?
- SEOがんばってる人用(ふつうの人は気にしなくていい)
- 「GEOは無駄」なのか? AI トラフィックをめぐる 3 つの調査とその反論
AI検索のKPI設定の違い
- SEOがんばってる人用(ふつうの人は気にしなくていい)
- この記事のキーワード
関連記事

Webサイトのメンテナンス中画面を出す正しい作法と.htaccessの書き方
2009年6月16日 11:00

出典の明記はグーグルのE-E-A-Tを高める効果あり!? スタンフォード大学も言ってるし【SEO情報まとめ】
2023年5月12日 7:00

ヤフーの検索結果は広告だらけ!? オーガニック検索はどこへ行った? など10+4記事
2014年7月25日 9:00

グーグル検索結果CTR調査【最新版】―― 1位CTRは19%~38%と業界格差が拡大【SEO情報まとめ】
2025年3月21日 7:00

グーグル検索のトップが交代、新トップは収益増加よりもUX改善を優先?【SEO情報まとめ】
2024年10月25日 7:00

あなたも同じミスをするかも? robots.txtのミスで予想外のページをクロール禁止していた悲劇【SEO情報まとめ】
2022年11月4日 7:00
バックナンバー


この記事の筆者

筆者の人気記事

「別タブで開く」リンク(target="_blank")は脆弱性あり?【SEO情報まとめ】
2020年3月13日 7:00

【重要】コアウェブバイタルとは? LCP/FID/CLSをわかりやすく解説【SEO情報まとめ】
2020年6月5日 7:00

新人に読ませておきたい「グーグルSEOでやったら本当にヤバいこと」【SEO記事12本まとめ】
2018年4月13日 7:00

グーグルが公式SEOチェックツールを公開【SEO記事11本まとめ】
2018年2月9日 7:00

もう待ったなし! グーグルが全サイトをMFIに強制移行へ(2020年9月予定)【SEO情報まとめ】
2020年3月27日 7:00

モバイルの「続きを読む」ボタンにグーグルの主要メンバーが不快感、将来は検索で不利になるのか?【SEO記事12本まとめ】
2017年2月10日 7:00