生成AIでコンテンツを作るのはやめるべき? 答えは「ノー」だが必ず含めるべき“視点”がある(前編)
生成AIで作ったコンテンツの課題を整理し、成果を出す「人間の視点(POV)」の重要性と取り入れ方を解説する。そこに「実体験」「意見」「行動を起こす明確な理由」はあるのか?
10月26日 7:05
優れたコンテンツを執筆してくれる高機能なAIエージェントを構築した
コンテンツマーケティングの拡大に伴うAIの役割について議論が高まっているいま、LinkedInを開くたびに、前述のように話す専門家たちの投稿を多数見かける。
こんな投稿も目にした。私の感想を添えて紹介しよう:
グーグルはAIコンテンツを検知できない
(確かにそうかもしれないが、AIコンテンツが問題なのではない)人間のトラフィックよりボットトラフィックのほうが多くなっているのだから、エージェント向けに書くべきだ
(誰でも100万個のボットを構築できるため、量は問題の一部にすぎない)我々のエージェント型ワークフローがコンテンツの品質を評価し、基準に達しないものは合格するまでループに戻される
(おめでとう、平凡な機能を自動化したわけだ)
ご覧のように、私はこうした形でのAI利用には積極的な姿勢ではない……では、AIを使って書くのはやめるべきだろうか?
簡単に言えば、答えは「ノー」だ。私はいつもAIを使って書いているが、それが問題なのではないと断言できる。
「AI執筆であることが検出されるか」にこだわるのは的外れだと思う。発見の手段がますます細分化しているなかで、より大きな問題は次の2点にある:
- コンテンツの品質
- オーナーシップの築き方
詳しく見ていこう。
まずは、核心的な問題から片付けよう
AIコンテンツが問題なのではない
グーグルは、「AIが使われている」というだけでコンテンツにペナルティを科すことはないようだ。同社の指針を見ると、ページが有用で信頼性があり、付加価値をもたらすように作られているかどうかに重点が置かれている。
Ahrefsのライアン・ロー氏のチームは、33万1000ページを調査してこれを確認した。
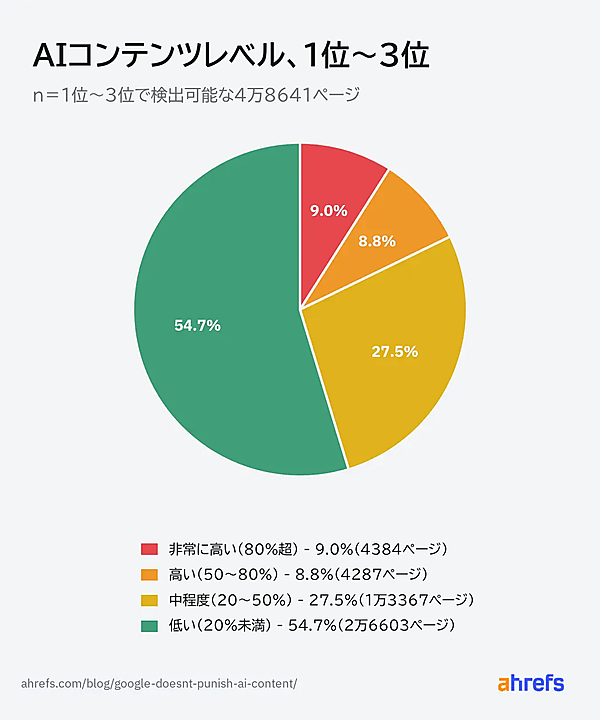
1位~3位に表示されたページの5.3%はすべてAIで生成されており、「AIコンテンツをインデックスから排除するフィルタ」の存在は確認できなかったという。ClaudeもAI生成テキストに透かしを入れるようになったが、それが検出にどれほど役立つかは現時点でまだ判断できない。
どちらにしても、「コンテンツをAIで作ったことをグーグルが検出できるか」を論じるのは、本質を見誤っていると思う。AIコンテンツをめぐる議論には、実際のところ次の4つの異なる問題が含まれている:
真正性:コンテンツの執筆者を偽ってはならない
品質:ハルシネーションや誤りを公開してはならない
スパム:検索順位を操作するためにページを大量生産してはならない
価値:付加価値のない二次的コンテンツを公開してはならない
私はMozCon NYCでの講演で、ブランドが最初の2つ(真正性・品質)を誤った場合にどうなるか、いくつか例を挙げた。
- Sports Illustratedは、執筆者のプロフィールを偽ってレビューを公開したことで真正性の問題に直面した。
- Gannettは、AIが生成したスポーツ関連記事に不自然な誤りが含まれていたことで品質の問題に直面した。
- Chicago Sun-Timesも、実在しない書籍を含む書評を公開したことで同じ問題に直面した。
いずれの事例もAIが絡んでいるが、それが失敗の原因ではない。問題は、3社とも編集者の確認を経ずにコンテンツを公開したことだ。そうした行為は、誰も正当化できない。
興味深いのは、価値についての議論だ。読み手にとってSERPに戻る必要がないほど有用なコンテンツなら、AIを使ったかどうかに関係なく、それは成功だと思う。
人間よりボットのほうが多いとしても、ボットのために書くべきではない
Impervaの『悪質なボットレポート2026年版(2026 Bad Bot Report)』によると、ボットトラフィックは現在ウェブトラフィック全体の53%超を占めており、前年の51%から増加したという。そう聞くと、次のような過激な意見が出てくる。
ヒューマンウェブ(人によるウェブ)は滅びつつあるのだから、これからはエージェント向けに記事を書こう
ボットの「数」だけでは、オーディエンスの行動についてほとんど何もわからない。自動化されたトラフィックには、次のようなものが含まれるほか、最近ではAIエージェントも増えている:
- 検索クローラー
- 監視ツール
- スクレイパー
- 悪意のあるボット
ボットは人間より速いペースで増えているが、人間のオーディエンスが減少したわけではない。ボットの数はオーディエンスに関する指標ではない。100万ページをリクエストするクローラーが100万人の顧客を生み出すわけではない。それに、ウェブトラフィックの半数近くは人間のままなので、将来の機会がエージェントにあるとしても、現時点でそこに人がいるのは確かだ。
私は、購買決定において今後エージェントの果たす役割が大きくなることについては確信している。優秀なエージェントであれば、ユーザーをウェブサイトに誘導することなく情報を収集してタスクを完了できるため、サイトのトラフィックが減少することさえある。そのため、参照トラフィックはエージェントの重要性を測る指標としては役に立たない。
しかし、次の2つの間には大きな隔たりがある:
- ウェブサイトにアクセスする機械(ボット)が増えている
- 何よりも機械のことを考えてコンテンツを作成すべきだ
また、グーグルの検索結果にはAI機能が含まれており、「検索最適化」と「AI最適化」の境界はすでにあいまいになりつつある。
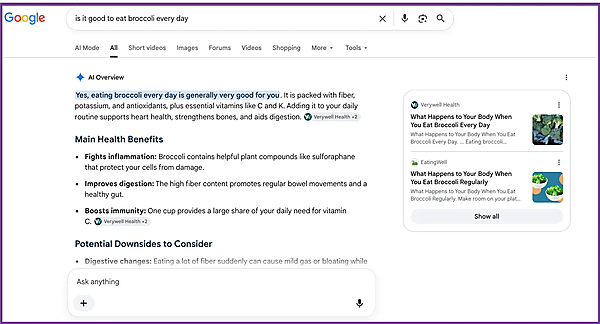
これらのプラットフォームの特徴として、ユーザーを自らのエコシステム内にとどめるように構築されている点がある。したがって、ビジビリティとは「借り物」であって、私たちサイトオーナーが「所有するもの」ではない。
にもかかわらず、私たちSEO担当者は、これを追求し続けている。その理由について、私には1つの考えがある。それは、「測定可能な指標」は私たちの好物だということだ。
この業界ではダッシュボードに表示できるものなら何でも欲しがる傾向がある。そして、測定可能な指標として、AI関連では次の3つの数字がある:
- ボットによるアクセス数
- クロール率
- AIサイテーション
たとえその測定値が、すでにある「トラフィック」や「コンバージョンのデータ」より悪いものであっても、やはり私たちはその数字を欲しくなってしまうのだ。
何を言いたいかというと、もちろんこういうことだ:
AIの数字だけを追いかけるのではなく、「従来の検索指標」と「AI検索指標」の両方を追跡し続けよう。
ただし、検索はサイロ化された単一チャネルの活動ではなく、エコシステムと考える必要がある。
Mozには、そのためのツールとしてMoz ProやMoz AI Visibilityがある。
役立たずのコンテンツモデルを自動化してもダメな状態は良くならない
私たちは、AIが登場するずっと前から情報コンテンツを台無しにしてきていた。
これは、私が過去の記事で指摘した点だ。
ユーザーのために書いていると自分に言い聞かせながら、実際にはグーグルのために書いていた。膨張したコンテンツクラスターを構築することで、あらゆる人にとって検索がしにくくなっていた。
以前に書いた記事の最後に、こんなふうに自問していくよう書いていた:
このコンテンツは、オーディエンスの課題を解決するだろうか、それともSERPのノイズを増やすだけだろうか?
実際にはどうだろう? コンテンツの世界はより良くなってきた気はしない。
そこで、少し振り返ってみよう。「生成型検索が登場する前のコンテンツ作成方法」と「現在のエージェント型コンテンツワークフロー」を比較するのだ。
- 生成型検索が登場する前のコンテンツ作成方法
スカイスクレイパーテクニック(多くの被リンクを集めているコンテンツより優れたものを作成することで、被リンクを獲得できるようにする手法)と最適化ツールを使ってアウトラインを作成する。
文字数を意識しながらコンテンツを書く。
エンティティに合わせて最適化し、コンテンツ最適化ソフトウェアにアップロードしてスコアで評価してもらう。
公開し、同じことを繰り返す。
- 現在のエージェント型コンテンツワークフロー
エージェントがSERPを調査し、上位に表示されているページから全体構成を作成する。
ほかのエージェントが既存のコンテンツを再利用してドラフトにする。
さらに違うエージェントが、ソートリーダーや社内の特定分野の専門家(SME)からの引用を用いてE-E-A-T(経験・専門性・権威性・信頼性)を盛り込む。
最後にエージェントが出力を評価し、基準を下回るものはすべて書き直すよう送り返す。
これは従来のコンテンツ戦略とどう違うだろうか?
はっきりさせておくが、私は自動化に反対しているわけではない。私自身も反復作業と感じるコンテンツプロセスの一部を自動化しており、皆にも同じことをするよう勧めたい。
私が問題を指摘したいのは、エンドツーエンドのコンテンツ自動化だ。君のコンテンツワークフローがいかに洗練されているように見えようと、そんなことはどうでもいい。そのループに専門家がいなければ、画一的なコンテンツを生み出していることになる点が問題なのだ。
AI生成コンテンツにはPOV(視点・観点)がないが、人々がお金を出す理由はPOVにある
私にとってAIスロップ(粗悪コンテンツ)に関する最大の問題は、そこにPOV(Point of View、視点・観点、特に一人称的な側面を指す)がないことだ。
ほとんどのAIワークフローは既存のコンテンツを分析することから始まり、次にスカイスクレイパーテクニックを用いてワードサラダを生成する。そこには「実体験」も「意見」も「行動を起こす明確な理由」もない。
一方、ニューヨーク・タイムズ(NYT)のような出版社は、人々が優れたコンテンツにはお金を出すことを証明している。
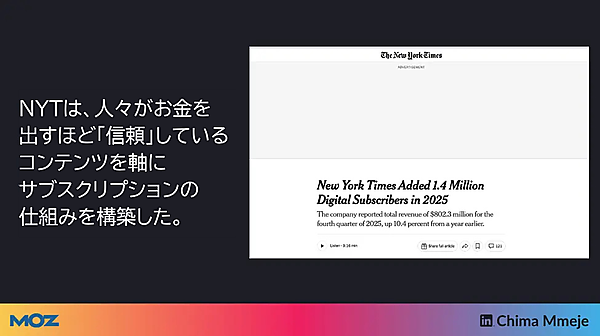
NYTは2025年にデジタル購読者が差し引き140万人増え、デジタル売上が初めて20億ドル(約3160億円)を突破した。2026年第1四半期にはさらに31万人増え、総数1310万人に達した。
他社がクリック数の減少に慌てている間に、これらの成果を上げたのだ。
この記事は、前後編の2回に分けてお届けする。後編となる次回は、コンテンツ作成のワークフローにAIをどう取り入れていくかを考察する。
(後編は11/2公開予定)
- この記事のキーワード
関連記事

AI検索時代の2026年を勝ち抜くサイトの条件とは? SEO専門家リリー・レイ氏が13のQ&Aで指導(前編)
4月6日 7:05

2024年のSEO/コンテンツをプロ27人が予測 ❰前編❱ SGEとSERP
2024年2月19日 7:00

AIに引用されやすい文章パターンとは? 120万件の検索結果と1万8千件の引用で判明したAIの“クセ”【SEOまとめ】
2月27日 7:05

SEOの仕事に生成AIをうまく使う方法【無料プロンプトジェネレータ付き】
2025年3月24日 7:00

SEOと認知バイアス: SERP編(顕著性バイアス、権威バイアス、親近性バイアス、ハロー効果など)
2024年8月5日 7:00

「ChatGPT」「検索依存の低減」「CTR」「未来の検索」 ~将来のSEOに備える17のヒント(後編)
2025年3月10日 7:00
バックナンバー


この記事の筆者
この記事は、Moz Blog に掲載された以下の記事を、Mozの許諾を得て日本語化したものです。

原文: 「Should We Stop Writing With AI?」 by Chima Mmeje (2026/08/20)
筆者の人気記事

link rel="canonical"のようなURL正規化タグをSEOで有効活用するには
2009年3月5日 9:00

検索エンジンが順位を決める53の要因(39人のSEOプロが評価した重要度とコメント付き)
2007年10月1日 9:30

ホームページをGoogle検索に引っかからないようにする12の方法
2008年2月14日 9:00

サーチコンソールのHTMLタグはどこに? 所有権の確認など初心者ガイド
2015年11月9日 7:00

SEO基本技術のチートシート(トラの巻)を作ってみた
2008年6月9日 9:00

滅べばいいのにと思うSEOの10の迷信(都市伝説)
2010年6月14日 9:00