

生成AIに社内文書を送る前に、個人情報を社内のPCだけで検出・マスキング。AI Librarium、東北大学との共著論文をCSS2026で発表
リリース情報提供元:
AI Librarium株式会社
ルール・辞書で候補を絞り、判断が難しい箇所だけをLLMが判定。日本語500文書の検証で、全文をLLMで処理する方式より約3.2倍高速で、検出精度も向上
AIコンサルティングおよびAIエージェント開発を手がけるAI Librarium株式会社(本社:東京都千代田区、代表取締役CEO:西川 智章、以下「AI Librarium」)は、2026年10月23日、情報処理学会 コンピュータセキュリティ研究会が主催する「コンピュータセキュリティシンポジウム2026(CSS2026)」において、東北大学の研究者との共著論文「個人識別情報保護に向けた正規表現ルールとローカルLLMによる軽量な事前検出手法」(執筆:朝比奈 睦郎氏)を発表しました。
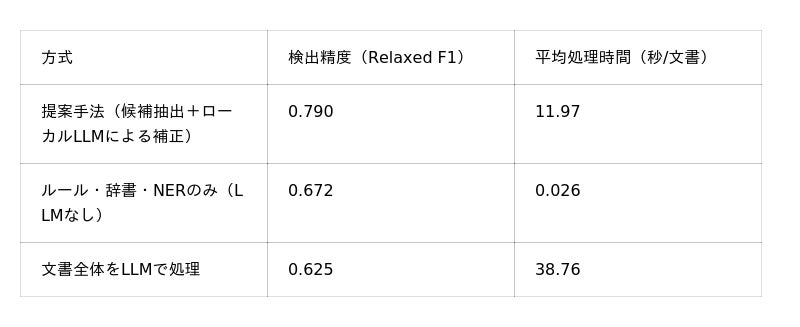
本手法は、社内文書を生成AIなどの外部サービスへ送る前に、氏名・住所・メールアドレスなどの個人識別情報(PII)を社内環境だけで検出・マスキングするものです。日本語500文書を用いた評価では、LLMを使わない構成に比べて検出精度(Relaxed F1※1)を0.672から0.790へ改善し、文書全体をLLMで処理する方式と比べて約3.2倍の速度で動作しました。
※1:検出の正確さと網羅性を総合的に示す指標。1に近いほど精度が高いことを示します。
研究の背景:生成AIの業務活用で、「送る前の個人情報対策」が課題に
生成AIの業務活用が広がる一方、社内文書をクラウドのAIサービスへ送る際に個人情報が含まれてしまうリスクは、多くの企業でAI活用を本格化させる際の障壁になっています。
メールアドレスや電話番号のように形式が決まった情報は、ルールで高速に検出できます。一方、氏名や住所は漢字・かな・ローマ字・敬称などで表記がゆれ、同じ語が人名にも地名にも一般名詞にもなり得るため、文脈を踏まえた判断が欠かせません。
こうした判断にはLLMの文脈理解が有効ですが、文書全体をLLMで処理すると時間がかかり、大量の文書を継続的に処理する用途には向きません。また、個人情報を検出するために、その個人情報をクラウドのAIへ送ることになっては本末転倒です。社内環境で動き、かつ実用的な速度で動く検出手法が求められていました。
1.候補抽出:正規表現・辞書・日本語NERで、個人情報の候補を高速に洗い出す
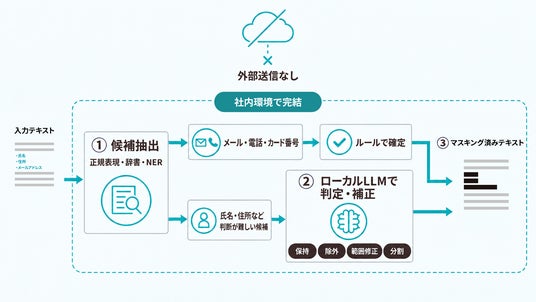
正規表現、都道府県名や一般的な日本人の姓などを収めた固定辞書、日本語の固有表現抽出(GiNZA)を組み合わせて候補を作ります。形式が明確なメールアドレス・電話番号・クレジットカード番号は、この段階でLLMを通さずに確定します。
2.ローカルLLMによる判定・補正:判断が難しい候補だけをLLMに任せる
氏名・住所など判断が難しい候補に限り、ローカル環境で動くLLM(gpt-oss:20b)が「保持」「除外」「範囲の修正」「分割」のいずれかを判定します。LLMの呼び出しは1文書につき最大1回で、LLMが判断するのは候補の内側に限られるため、処理時間を抑えられます。
3.日本語を含むメールアドレスにも対応
「市石@ example.com 」のように、@の左側に日本語を含むメールアドレスは、本文との境目を文字の種類だけでは判定できません。本手法では候補をあえて広めに取り、LLMが文脈から正しい範囲を切り出します。
すべての処理は社内のPC・サーバー上で完結するため、検出対象の個人情報を外部へ送信する必要はありません。
主な評価結果:精度と速度を両立
公開データセット「OpenPII 1.5M」の日本語文書のうち、手法の開発に使っていない500文書で評価しました。ルールやLLMへの指示文は評価前に固定しています。提案手法は比較した5方式の中で最も高い精度を示し、文書全体をLLMで処理する方式より約3.2倍速く動作しました。
(下表は主な3方式を抜粋)
- メールアドレスの検出精度は0.558から0.971へ、氏名は0.581から0.745へ向上(いずれもLLMなし構成との比較)
- 500文書中74文書(14.8%)は、LLMを一度も呼び出さずに処理を完了
- 計測は一般的なPC(GPU:NVIDIA GeForce RTX 4060 8GB、メモリ16GB)で実施
住所・電話番号では、LLMなし構成との明確な差は確認されませんでした。候補抽出の網羅性の向上や、実際の業務文書での検証を今後の課題としています。
発表概要
学会:コンピュータセキュリティシンポジウム2026(CSS2026)
主催:一般社団法人情報処理学会 コンピュータセキュリティ研究会
発表日:2026年10月23日
題目:個人識別情報保護に向けた正規表現ルールとローカルLLMによる軽量な事前検出手法
著者:朝比奈 睦郎(愛媛大学)、原 賢太、塚原 健太郎、三澤 匠、西川 智章(以上、AI Librarium株式会社)、栗林 稔(東北大学 データ駆動科学・AI教育研究センター)
代表取締役CEO 西川 智章 コメント
生成AIを業務で本格的に使おうとすると、必ず「個人情報を含む文書をどう扱うか」という壁に突き当たります。止めてしまえば業務は進まず、そのまま送ればリスクになる。私たちは、AI活用を止めずに安全性を確保する仕組みが必要だと考えてきました。
本研究では、ルールとLLMの役割を分け、LLMには本当に判断が必要な箇所だけを任せることで、一般的なPC上でも実用的な精度と速度を両立できることを示しました。大学の研究者の皆さまと共に得たこの知見を、企業のAIガバナンス支援の現場に還元し、日本企業が安心してAIを使える環境づくりを進めてまいります。
今後の展望
AI Librariumは今後、本研究の成果を、 企業向けAIガバナンス支援サービス「AIL Governance X」をはじめとする、AI活用時の安全対策(ガードレール)の取り組みに活かしていきます。
AIL Governance X: https://ailibrarium.com/news/pBclbnjf
あわせて、候補抽出の網羅性の向上、年齢や運転免許証番号などの検出対象の拡張、実際の業務文書での検証を進めます。
AI Librariumは今後も「AIで、日本の『働く』をアップデートする」をビジョンに掲げ、企業が安心してAIを事業成果につなげられる仕組みづくりを支援してまいります。
AI Librarium について
2025年9月に設立されたAIコンサルティング企業です。「AIで、日本の『働く』をアップデートする」を掲げ、大手SIer、コンサルティング企業を中心に、AI戦略の策定から業務変革、AIエージェントの実装、AIガバナンス設計までを一貫して支援しています。AI案件で培われた実践知や専門家の暗黙知を、AIが実行可能な「Skill」として体系化し、組織の中で蓄積・改善・継承できる仕組みづくりを推進しています。
代表者略歴
代表取締役CEO 西川 智章
富士通にてシステムエンジニアとして従事した後、PwCコンサルティングにて大手企業のAI戦略立案を担当。自ら創業したAIスタートアップを住友商事、DBJキャピタル等からの資金調達を経て成長させ、上場企業へ売却。総合商社のDX支援では1,000名以上のAIビジネスプロデューサー育成を担当。東北大学 データ駆動科学・AI教育研究センター 特任准教授(客員)、米国公認会計士(ワシントン州)。AI監査に関する書籍の執筆経験を持つ。
会社概要
会社名:AI Librarium(アイブリウム)株式会社
所在地:東京都千代田区丸の内1-6-5 丸の内北口ビルディング9F
代表者:代表取締役CEO 西川 智章
設立:2025年9月1日
事業内容:AIコンサルティング/AIエージェント開発/AI人材育成
公式サイト:https://ailibrarium.com/
研究内容・サービスに関するお問い合わせ:[email protected](担当:塚原)
※記載の会社名・製品名は、各社の商標または登録商標です。
企業プレスリリース詳細へ
PR TIMESトップへ
ルール・辞書で候補を絞り、判断が難しい箇所だけをLLMが判定。日本語500文書の検証で、全文をLLMで処理する方式より約3.2倍高速で、検出精度も向上
AIコンサルティングおよびAIエージェント開発を手がけるAI Librarium株式会社(本社:東京都千代田区、代表取締役CEO:西川 智章、以下「AI Librarium」)は、2026年10月23日、情報処理学会 コンピュータセキュリティ研究会が主催する「コンピュータセキュリティシンポジウム2026(CSS2026)」において、東北大学の研究者との共著論文「個人識別情報保護に向けた正規表現ルールとローカルLLMによる軽量な事前検出手法」(執筆:朝比奈 睦郎氏)を発表しました。
本手法は、社内文書を生成AIなどの外部サービスへ送る前に、氏名・住所・メールアドレスなどの個人識別情報(PII)を社内環境だけで検出・マスキングするものです。日本語500文書を用いた評価では、LLMを使わない構成に比べて検出精度(Relaxed F1※1)を0.672から0.790へ改善し、文書全体をLLMで処理する方式と比べて約3.2倍の速度で動作しました。
※1:検出の正確さと網羅性を総合的に示す指標。1に近いほど精度が高いことを示します。
研究の背景:生成AIの業務活用で、「送る前の個人情報対策」が課題に
生成AIの業務活用が広がる一方、社内文書をクラウドのAIサービスへ送る際に個人情報が含まれてしまうリスクは、多くの企業でAI活用を本格化させる際の障壁になっています。
メールアドレスや電話番号のように形式が決まった情報は、ルールで高速に検出できます。一方、氏名や住所は漢字・かな・ローマ字・敬称などで表記がゆれ、同じ語が人名にも地名にも一般名詞にもなり得るため、文脈を踏まえた判断が欠かせません。
こうした判断にはLLMの文脈理解が有効ですが、文書全体をLLMで処理すると時間がかかり、大量の文書を継続的に処理する用途には向きません。また、個人情報を検出するために、その個人情報をクラウドのAIへ送ることになっては本末転倒です。社内環境で動き、かつ実用的な速度で動く検出手法が求められていました。
手法の特徴:ルールとLLMの役割を分け、LLMの仕事を「曖昧な候補の判定」に絞る
本手法は、高速なルール処理と、LLMの文脈理解を組み合わせた二段階の構成をとります。1.候補抽出:正規表現・辞書・日本語NERで、個人情報の候補を高速に洗い出す
正規表現、都道府県名や一般的な日本人の姓などを収めた固定辞書、日本語の固有表現抽出(GiNZA)を組み合わせて候補を作ります。形式が明確なメールアドレス・電話番号・クレジットカード番号は、この段階でLLMを通さずに確定します。
2.ローカルLLMによる判定・補正:判断が難しい候補だけをLLMに任せる
氏名・住所など判断が難しい候補に限り、ローカル環境で動くLLM(gpt-oss:20b)が「保持」「除外」「範囲の修正」「分割」のいずれかを判定します。LLMの呼び出しは1文書につき最大1回で、LLMが判断するのは候補の内側に限られるため、処理時間を抑えられます。
3.日本語を含むメールアドレスにも対応
「市石@ example.com 」のように、@の左側に日本語を含むメールアドレスは、本文との境目を文字の種類だけでは判定できません。本手法では候補をあえて広めに取り、LLMが文脈から正しい範囲を切り出します。
すべての処理は社内のPC・サーバー上で完結するため、検出対象の個人情報を外部へ送信する必要はありません。
主な評価結果:精度と速度を両立
公開データセット「OpenPII 1.5M」の日本語文書のうち、手法の開発に使っていない500文書で評価しました。ルールやLLMへの指示文は評価前に固定しています。提案手法は比較した5方式の中で最も高い精度を示し、文書全体をLLMで処理する方式より約3.2倍速く動作しました。
(下表は主な3方式を抜粋)
- メールアドレスの検出精度は0.558から0.971へ、氏名は0.581から0.745へ向上(いずれもLLMなし構成との比較)
- 500文書中74文書(14.8%)は、LLMを一度も呼び出さずに処理を完了
- 計測は一般的なPC(GPU:NVIDIA GeForce RTX 4060 8GB、メモリ16GB)で実施
住所・電話番号では、LLMなし構成との明確な差は確認されませんでした。候補抽出の網羅性の向上や、実際の業務文書での検証を今後の課題としています。
発表概要
学会:コンピュータセキュリティシンポジウム2026(CSS2026)
主催:一般社団法人情報処理学会 コンピュータセキュリティ研究会
発表日:2026年10月23日
題目:個人識別情報保護に向けた正規表現ルールとローカルLLMによる軽量な事前検出手法
著者:朝比奈 睦郎(愛媛大学)、原 賢太、塚原 健太郎、三澤 匠、西川 智章(以上、AI Librarium株式会社)、栗林 稔(東北大学 データ駆動科学・AI教育研究センター)
代表取締役CEO 西川 智章 コメント
生成AIを業務で本格的に使おうとすると、必ず「個人情報を含む文書をどう扱うか」という壁に突き当たります。止めてしまえば業務は進まず、そのまま送ればリスクになる。私たちは、AI活用を止めずに安全性を確保する仕組みが必要だと考えてきました。
本研究では、ルールとLLMの役割を分け、LLMには本当に判断が必要な箇所だけを任せることで、一般的なPC上でも実用的な精度と速度を両立できることを示しました。大学の研究者の皆さまと共に得たこの知見を、企業のAIガバナンス支援の現場に還元し、日本企業が安心してAIを使える環境づくりを進めてまいります。
今後の展望
AI Librariumは今後、本研究の成果を、 企業向けAIガバナンス支援サービス「AIL Governance X」をはじめとする、AI活用時の安全対策(ガードレール)の取り組みに活かしていきます。
AIL Governance X: https://ailibrarium.com/news/pBclbnjf
あわせて、候補抽出の網羅性の向上、年齢や運転免許証番号などの検出対象の拡張、実際の業務文書での検証を進めます。
AI Librariumは今後も「AIで、日本の『働く』をアップデートする」をビジョンに掲げ、企業が安心してAIを事業成果につなげられる仕組みづくりを支援してまいります。
AI Librarium について
2025年9月に設立されたAIコンサルティング企業です。「AIで、日本の『働く』をアップデートする」を掲げ、大手SIer、コンサルティング企業を中心に、AI戦略の策定から業務変革、AIエージェントの実装、AIガバナンス設計までを一貫して支援しています。AI案件で培われた実践知や専門家の暗黙知を、AIが実行可能な「Skill」として体系化し、組織の中で蓄積・改善・継承できる仕組みづくりを推進しています。
代表者略歴
代表取締役CEO 西川 智章
富士通にてシステムエンジニアとして従事した後、PwCコンサルティングにて大手企業のAI戦略立案を担当。自ら創業したAIスタートアップを住友商事、DBJキャピタル等からの資金調達を経て成長させ、上場企業へ売却。総合商社のDX支援では1,000名以上のAIビジネスプロデューサー育成を担当。東北大学 データ駆動科学・AI教育研究センター 特任准教授(客員)、米国公認会計士(ワシントン州)。AI監査に関する書籍の執筆経験を持つ。
会社概要
会社名:AI Librarium(アイブリウム)株式会社
所在地:東京都千代田区丸の内1-6-5 丸の内北口ビルディング9F
代表者:代表取締役CEO 西川 智章
設立:2025年9月1日
事業内容:AIコンサルティング/AIエージェント開発/AI人材育成
公式サイト:https://ailibrarium.com/
本件に関するお問い合わせ
報道関係者向け:[email protected](担当:栄利)研究内容・サービスに関するお問い合わせ:[email protected](担当:塚原)
※記載の会社名・製品名は、各社の商標または登録商標です。
企業プレスリリース詳細へ
PR TIMESトップへ
このページでは、PR TIMESから提供されたニュースリリース情報を表示しています。