

LitMedia、AI動画生成モデルを横断検証する技術レポートを公開|Veo3・Sora2・Hailuo 2.3 など7種を徹底検証
リリース情報提供元:
Wheatfield Guard Technology Co., Ltd.
AI動画生成モデル深度検証レポート
近年、AI動画生成技術は急速に普及しており、企業やクリエイターの動画制作環境に大きな変革をもたらしています。市場調査によると、2023年のグローバルAI動画生成器市場規模は約5.549億米ドルと推定され、2024年から2030年にかけて年平均成長率(CAGR)19.9%で拡大し、2030年には約19.5924億米ドルに達すると予測されています。
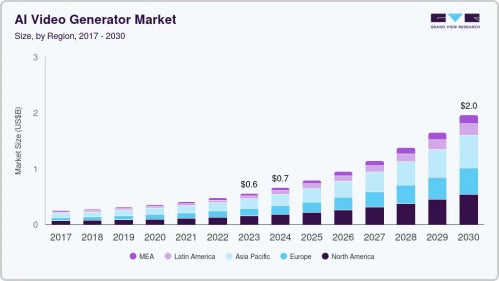
データ出典:Grand View Research
特に2025年以降、Veo 3(Google)や Sora 2(OpenAI)をはじめとする新世代モデルの登場により、AI動画生成は用途や性能特性の多様化が一層進んでいます。
一方で、各モデルの性能差や得意分野を横断的かつ客観的に比較できる情報は依然として限られており、企業やクリエイターにとって「どのモデルを、どの目的で選択すべきか」を判断することは容易ではありません。市場の拡大とともに、実運用を前提とした評価指標や検証データの重要性が高まっています。
こうした背景を受け、LitMedia が提供するAI動画生成プロダクト「LitVideo」は、主要なAI動画生成モデル10種以上を対象とした技術検証レポートを公開しました。本検証では、すべてのモデルを統一条件下で比較し、生成品質、指示理解力、音声と映像の同期精度、物理表現の傾向などを多角的に分析しています。本稿では、その検証結果をもとに、AI動画生成市場の現状と各モデルの技術的特性を整理します。
なお、LitMedia はAI動画生成、AI画像生成、AI音楽制作などを包括的に提供するAIテクノロジー企業が運営する総合クリエイティブプラットフォームです。複数の最先端生成モデルを統合し、誰でもブラウザ上で高品質なコンテンツ制作を行える環境を構築しています。現在は、最新世代モデル「Sora 2」を期間限定で無料体験 できるキャンペーンも実施しています。
これを踏まえ、LitMedia が公開した測評レポートでは、検証対象となったAI動画生成モデルを、性能特性および想定ユースケースの観点から3つのカテゴリに整理しています。
第一のカテゴリは、映像と音声を一体で生成し、高度な物理再現や演出表現を志向する最上位モデル群です。
本グループには、Google が開発した Veo 3 と、OpenAI による Sora 2 が含まれ、映画的表現や物語性の高い動画生成を想定した設計が共通の特徴とされています。音声生成やリップシンクを含む統合的な表現力は、現行市場における技術的上限に近い位置づけといえます。
第二のカテゴリは、映像制御精度やスタイル一貫性、制作効率を重視した高性能モデル群です。
ここには、Hailuo 2.3(MiniMax)、Seedance(ByteDance)、および Wan 2.2 が含まれます。
これらのモデルは、必ずしも音声生成を主軸とせず、量産性、映像の安定性、運動表現や構図制御といった要素を重視する設計が特徴です。広告素材、ブランド動画、反復的な制作フローなど、実務用途での効率性を意識した技術的方向性が確認されました。
第三のカテゴリは、即時生成性と操作性を重視し、配信・プロモーション用途に適応したモデル群です。
本グループには、PixVerse および Vidu が該当します。
短時間での生成、直感的な操作性、縦型・正方形など多様な配信フォーマットへの対応力が重視されており、SNSコンテンツや情報流通型動画の制作を前提とした設計思想が見られます。特に Vidu は、画像参照を活用したキャラクター一貫性や表情表現といった点で独自の方向性を示しています。
このような分類は、AI動画生成市場が「単一指標による性能競争」から、用途別に最適化されたモデルを選択・併用するフェーズへ移行していることを示すものです。
以下では、各カテゴリごとに代表的なモデルの技術的特徴と、同一条件下での検証結果から確認された傾向を整理します。
環境音、効果音、人物の対話、背景音楽までを含めて自動生成できることが確認されており、特に唇の動きと音声を同期させるリップシンク機能は、人物会話シーンの自然さを大きく向上させています。
検証では、自然光の表現や空間全体の雰囲気構築において高い完成度が確認され、現実世界の物理挙動に対する理解の深さが映像全体の説得力につながっていることが明らかになりました。一方で、指示内容が極めて詳細かつ複雑な場合には、意図の解釈が硬直化し、シーンの一貫性や物理的整合性が低下するケースも確認されています。
同一プロンプトによる生成結果の比較について
AI動画生成モデル深度検証レポート
近年、AI動画生成技術は急速に普及しており、企業やクリエイターの動画制作環境に大きな変革をもたらしています。市場調査によると、2023年のグローバルAI動画生成器市場規模は約5.549億米ドルと推定され、2024年から2030年にかけて年平均成長率(CAGR)19.9%で拡大し、2030年には約19.5924億米ドルに達すると予測されています。
データ出典:Grand View Research
特に2025年以降、Veo 3(Google)や Sora 2(OpenAI)をはじめとする新世代モデルの登場により、AI動画生成は用途や性能特性の多様化が一層進んでいます。
一方で、各モデルの性能差や得意分野を横断的かつ客観的に比較できる情報は依然として限られており、企業やクリエイターにとって「どのモデルを、どの目的で選択すべきか」を判断することは容易ではありません。市場の拡大とともに、実運用を前提とした評価指標や検証データの重要性が高まっています。
こうした背景を受け、LitMedia が提供するAI動画生成プロダクト「LitVideo」は、主要なAI動画生成モデル10種以上を対象とした技術検証レポートを公開しました。本検証では、すべてのモデルを統一条件下で比較し、生成品質、指示理解力、音声と映像の同期精度、物理表現の傾向などを多角的に分析しています。本稿では、その検証結果をもとに、AI動画生成市場の現状と各モデルの技術的特性を整理します。
なお、LitMedia はAI動画生成、AI画像生成、AI音楽制作などを包括的に提供するAIテクノロジー企業が運営する総合クリエイティブプラットフォームです。複数の最先端生成モデルを統合し、誰でもブラウザ上で高品質なコンテンツ制作を行える環境を構築しています。現在は、最新世代モデル「Sora 2」を期間限定で無料体験 できるキャンペーンも実施しています。
次世代・高品質志向モデルを中心としたAI動画生成の分類動向
本検証では、生成品質や音声統合の完成度といった技術指標に加え、実運用における用途適性の違いが複数のモデル間で明確に確認されました。これを踏まえ、LitMedia が公開した測評レポートでは、検証対象となったAI動画生成モデルを、性能特性および想定ユースケースの観点から3つのカテゴリに整理しています。
第一のカテゴリは、映像と音声を一体で生成し、高度な物理再現や演出表現を志向する最上位モデル群です。
本グループには、Google が開発した Veo 3 と、OpenAI による Sora 2 が含まれ、映画的表現や物語性の高い動画生成を想定した設計が共通の特徴とされています。音声生成やリップシンクを含む統合的な表現力は、現行市場における技術的上限に近い位置づけといえます。
第二のカテゴリは、映像制御精度やスタイル一貫性、制作効率を重視した高性能モデル群です。
ここには、Hailuo 2.3(MiniMax)、Seedance(ByteDance)、および Wan 2.2 が含まれます。
これらのモデルは、必ずしも音声生成を主軸とせず、量産性、映像の安定性、運動表現や構図制御といった要素を重視する設計が特徴です。広告素材、ブランド動画、反復的な制作フローなど、実務用途での効率性を意識した技術的方向性が確認されました。
第三のカテゴリは、即時生成性と操作性を重視し、配信・プロモーション用途に適応したモデル群です。
本グループには、PixVerse および Vidu が該当します。
短時間での生成、直感的な操作性、縦型・正方形など多様な配信フォーマットへの対応力が重視されており、SNSコンテンツや情報流通型動画の制作を前提とした設計思想が見られます。特に Vidu は、画像参照を活用したキャラクター一貫性や表情表現といった点で独自の方向性を示しています。
このような分類は、AI動画生成市場が「単一指標による性能競争」から、用途別に最適化されたモデルを選択・併用するフェーズへ移行していることを示すものです。
以下では、各カテゴリごとに代表的なモデルの技術的特徴と、同一条件下での検証結果から確認された傾向を整理します。
音声統合と物理再現を軸に進化する最上位生成モデルVeo 3(Google)
Google が2025年5月に発表した Veo 3 は、単一の指示から映像と音声を同時に生成できる点で、従来のAI動画生成技術とは一線を画しています。環境音、効果音、人物の対話、背景音楽までを含めて自動生成できることが確認されており、特に唇の動きと音声を同期させるリップシンク機能は、人物会話シーンの自然さを大きく向上させています。
検証では、自然光の表現や空間全体の雰囲気構築において高い完成度が確認され、現実世界の物理挙動に対する理解の深さが映像全体の説得力につながっていることが明らかになりました。一方で、指示内容が極めて詳細かつ複雑な場合には、意図の解釈が硬直化し、シーンの一貫性や物理的整合性が低下するケースも確認されています。
同一プロンプトによる生成結果の比較について
このページでは、PR TIMESから提供されたニュースリリース情報を表示しています。